散布図は、どの観測が似ているかを示す。しかし、どの点が先だったかは散布図だけでは分からない。 Trajectory MLは、この違いから始まる。
会話に「分かった、君を信じる」という文が現れたとする。誠実な謝罪の後かもしれないし、脅しに屈した返答かもしれない。見える文は同じでも、関係の状態と次の行動は異なり得る。細胞でも同様の測定問題がある。遺伝子発現量は観測できるが、発達状態はそこから推測する。
この講義はアルゴリズムの名前を順番に覚える授業ではない。何を観測すれば、状態、経路、動き、最終結果を推定できるのかという問いを、12回にわたって異なる道具で解く。
準備と90分の進め方
Pythonの配列、ベクトル、平均、基礎確率を前提とする。生物学の予備知識は不要だ。事例15分、観測モデル20分、合成実験20分、実習20分、主張と限界の検討15分で進める。終了時には、座標、順序、速度、結果予測を区別して説明できるようになろう。
環境と共通資料を確認し、実習一式を展開する。lesson01.pyは同梱のcommon.pyと一緒に使う。データはすべてローカルで生成し、アカウントや外部データの取得は必要ない。
一つの観測に複数の説明がある
一回の観測を$x\in\mathbb R^D$と書く。各成分は、正規化した遺伝子発現量、会話埋め込みの座標、あるいは会話から計測した特徴かもしれない。その背後に低次元の状態$z\in\mathbb R^d$、$d\ll D$を仮定する。
$$ x=g(z)+\epsilon. $$$g$は状態を観測へ写す関数、$\epsilon$は測定雑音と説明できなかった変動だ。本プロジェクトでは二つの状態座標から24個の観測特徴を作る。実際の細胞測定で遺伝子が約2万個あっても、変化の独立した原因が2万個あるとは限らない。
この式は唯一の正しい状態が存在する証明ではない。可逆な$h$で$z'=h(z)$、$g'=g\circ h^{-1}$と置けば、観測は変わらない。完全に復元できても、第1軸が「信頼」、第2軸が「成熟度」と決まるわけではない。意味を付けるには独立した測定や追加の仮定が必要だ。この識別可能性の問題は、Locatelloらの教師なし表現学習研究にもつながる。
2Dの例を固定しよう。点は最初一緒に右へ進み、途中から上下に分かれる。横は進行、縦は分岐の向きだ。生成器はこの二つを非線形に混ぜ、雑音を加えて24個の測定値を作る。学習器が受け取るのは測定値であり、正解座標ではない。
五つの問いを分ける
シリーズ全体の軸は次の連鎖だ。
$$ \boxed{x\rightarrow z\rightarrow\text{trajectory}\rightarrow\text{dynamics}\rightarrow\text{fate}}. $$表現学習は状態に何を残すかを問う。幾何はどの状態が近いかを問う。経路推定は状態の接続や分岐を問う。動力学は指定した時間幅で状態がどう変わるかを問う。結果予測は現在利用できる情報から終点の確率を求める。それぞれ新しい主張を加えている。
点群がY字型なら、分岐構造を提案できる。しかし一つの集団が二つになったのか、二つが合流したのか、別々の過程が同じ形に並んだのかは決まらない。始点のラベル、採取時刻、同じ個体の連続観測、系譜追跡などが方向の根拠になる。何を使ったのかを明記しよう。
擬似時間は提案した経路上の順序であり、実時間は時計の測定だ。点が密集した区間も、移動が遅いとは限らない。採取が多かった、細胞が増殖した、という説明もある。密度だけでは区別できない。この違いは集団の輸送を扱うときに再び重要になる。
12講共通の実験
生成器は120セッションを作り、各セッションに16個の順序付き観測を置く。一行が一観測、セッションが一つの連結した系列だ。Xは特徴、time、session、next_indexは時間と接続情報を保持する。branchとz_trueはシミュレーターの正解であり、明示した評価や正解参照の図だけに使う。
後半にはセッション単位の結果と無作為化した処置も登場する。それらをこっそりXに追加しない。ベースラインは処置前に測定する。役割を分けることで、現在状態の予測に未来の結果が漏れるのを防ぐ。
学習と評価はセッション丸ごとで分割する。同じ系列の隣接観測をランダムに振り分けると、評価する場面とほぼ同じ場面を学習で見てしまう。本設定では学習90、評価30セッションだ。新しい利用者への一般化を主張するなら利用者単位、細胞研究ならドナー単位の分割が必要なこともある。実際に新しく出会う単位と、評価で隠す単位を合わせる。scikit-learnのグループ交差検証資料に対応する分割器がある。
最初の監査を実行する
展開した実習ディレクトリで実行する。
from pathlib import Path
from lesson01 import run

metrics = run(Path("outputs"))
print(metrics)
完全版は学習セッションだけで前処理とPCAを適合し、全観測を変換する。その後、評価セッション一つを記録順に描く。学習と評価のセッションIDが重ならず、次の観測が同じセッションに属し、その時刻が増加することも確認する。これはデータの契約の検証であり、PCAが生物学を復元した証拠ではない。
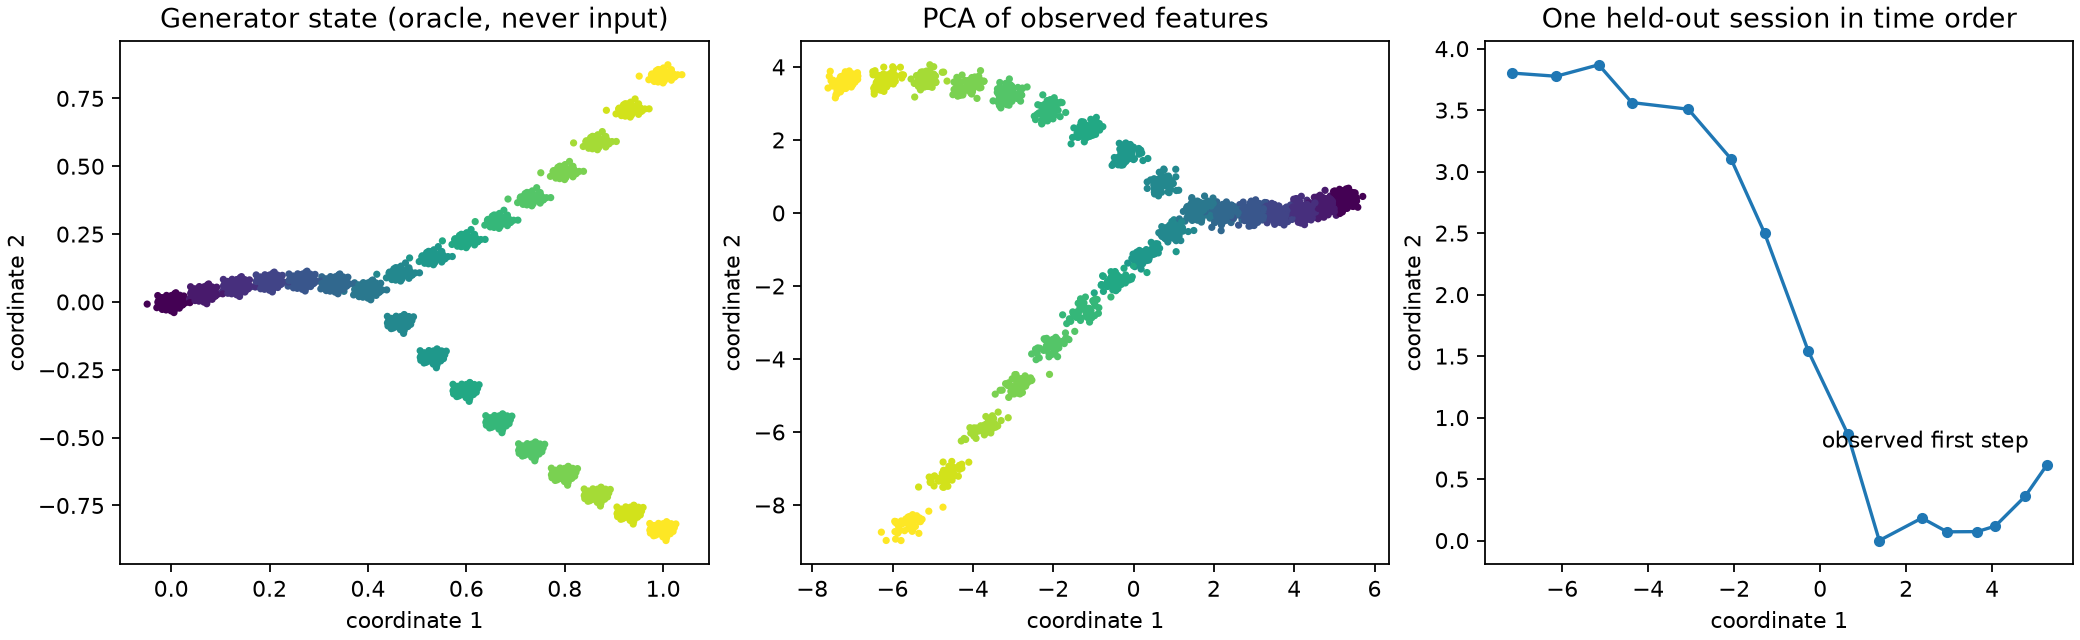
第1図は意図的にz_trueを示す正解参照だ。第2図は観測から学んだ座標である。どちらも有用な構造を表していても、軸の向きや値は一致しなくてよい。色は記録時刻を表示するが、PCAの学習には使わない。第3図では、順序なしのスナップショットにはない系列情報を使っている。
コードは行順をシャッフルして特徴平均も比較する。浮動小数点誤差を除いて平均は同じだ。点集合も変わらない。その集合に与える時間方向を反転しても散布図は同じである。スナップショットから方向が決まらないことを、短い実験で確認できる。
二つの分野の共通点と違い
単一細胞測定では測定時に細胞を消費する手法が多い。その場合、異なる採取時刻の観測は同じ細胞の再測定ではない。接続には集団についての仮定や系譜情報が要る。「この細胞があの細胞になった」は「発達の連続体らしい」より強い主張だ。
会話にはターン順があることが多いが、一ターンは一定時間ではない。短い20ターンと長い20ターンでは、経過時間も物語の進行量も異なり得る。文脈窓を重ねれば隣接観測は入力の大部分を共有する。遷移モデルを作る前に、観測単位、窓、時計を定義する。
両分野で数学の道具は共有できても、測定過程まで同一ではない。会話埋め込みの差分はRNA velocityではなく、細胞クラスタがキャラクターの意図に自動対応するわけでもない。転用すべきなのは、観測と推測を分ける姿勢だ。
演習と解説
- 順序を反転する。 同じ点を逆順に接続すると何が変わるか。答え: 有向遷移は変わる。平均と無向の幾何は変わらない。スナップショットだけの推定器は追加仮定なしに方向を選べない。
- 入力列を監査する。 3ターン目の予測に最終セッション長を使ってよいか。答え: 通常は不可。その時点で得られない未来情報だからだ。現在までのターン数は別の変数だが、収集法や打ち切りとの関係は確認する。
- 一般化先を決める。 セッション分割で新規利用者への一般化を検証できるか。ヒント: 一人が複数のセッションを持つ。利用者を丸ごと分離し、キャラクターの共有状況も報告する必要がある。
提出物は図一枚と短い主張の記録だ。図が直接示すこと、追加で推測したこと、それを確かめる測定を書く。次回はPCAを使って最初の状態表現を正確な数式で定義する。