PCAは変動をできるだけ残す平らな座標系を選ぶ。最初の状態表現に適するのは、目的が明確で解を調べられ、失敗も実験しやすいからだ。
二つの特徴がほぼ一緒に増えると、点は斜めに長い雲を作る。両座標には重複した情報がある。長い軸上の位置だけを記録しても変動の多くは残る。軸から垂直に離れた距離が圧縮で失う情報だ。PCAはこの選択を厳密にする。
準備と90分の構成
行列積、内積、微分の考え方を前提とし、固有ベクトルは講義内で導入する。2Dの雲15分、導出30分、SVD15分、実習20分、解釈10分で進める。提出物は次元数と復元誤差の曲線、および次元選択の根拠だ。
環境案内、実習一式、lesson02.pyを利用する。第1講と同じ合成セッションを使い続ける。
方向を選ぶ前に中心化する
学習観測を行に並べた$X\in\mathbb R^{n\times D}$を考える。学習平均$\mu$から、中心化行列と標本共分散を作る。
$$ X_c=X-\mathbf1\mu^\top,\qquad S=\frac1{n-1}X_c^\top X_c. $$対角成分$S_{jj}$は特徴$j$の標本分散だ。非対角成分$S_{jk}$は共分散であり、中心化後の二特徴が同じ符号を取りやすければ正になる。共分散には単位があるため、数値の大きな単位を使った特徴が支配することがある。
次の小例を計算しよう。
$$ S=\begin{bmatrix}4&3\\3&4\end{bmatrix}. $$$(1,1)/\sqrt2$方向の分散は7、$(1,-1)/\sqrt2$方向は1だ。最初の方向だけで全分散の$7/8$を保持する。行列とベクトルの積を二回計算すれば確認できる。共分散行列を掛けても方向が変わらず長さだけが変わるベクトルが固有ベクトルで、$Sw=\lambda w$と書く。
中心化を省くと、雲の内部変動ではなく原点から雲への方向が支配する場合がある。スケーリングは別の選択だ。実習では学習平均と標準偏差で特徴を標準化するため、最適化するのは元の単位ではなく標準化単位での復元誤差である。scikit-learnのPCA説明にもあるように、PCA自身は中心化するが特徴スケールはそろえない。
復元からPCAを導く
$W\in\mathbb R^{D\times d}$の列に、互いに直交する長さ1の方向を並べる。したがって$W^\top W=I_d$だ。圧縮した座標を$Z\in\mathbb R^{n\times d}$とし、$ZW^\top$で復元する。
$$ \min_{W,Z}\|X_c-ZW^\top\|_F^2 \quad\text{subject to }W^\top W=I_d. $$$W$を固定して$Z$で微分すると、最適な座標は$Z=X_cW$になる。復元は直交射影$X_cWW^\top$だ。代入すると
$$ \|X_c-X_cWW^\top\|_F^2 =\|X_c\|_F^2-\operatorname{tr}(W^\top X_c^\top X_cW) $$を得る。第1項は固定なので、失うエネルギーを最小化することは残す分散を最大化することに等しい。
一軸なら$w^\top w=1$の制約下で$w^\top Sw$を最大化する。ラグランジュ乗数法から$Sw=\lambda w$となり、最大固有値の方向が答えだ。次の軸は直交制約のもとで次に大きい固有値の方向を選ぶ。
2Dの小例では一軸を残すと分散1を捨て、二軸なら誤差0になる。しかし全次元で学習復元誤差が0でも、有用な状態を発見したことにはならない。雑音も含めて全部を残しただけだ。
SVDは同じ解につながる
中心化データを直接分解する。
$$ X_c=U\Sigma V^\top. $$すると$X_c^\top X_c=V\Sigma^2V^\top$なので、上位右特異ベクトルがPCA方向、座標が$Z=U_d\Sigma_d$、説明分散が$\lambda_j=\sigma_j^2/(n-1)$となる。PCAとSVDは独立した暗記項目ではなく、同じ中心化データに対する分解の関係だ。
最適なランク$d$復元の二乗誤差は、捨てた特異値の二乗和になる。
$$ \|X_c-X_{c,d}\|_F^2=\sum_{j>d}\sigma_j^2. $$実習では実際の復元誤差とこの和を比較し、SVD射影とscikit-learn射影も比較する。生の固有ベクトルではなく射影を比較するのがポイントだ。符号を反転しても同じ部分空間だし、固有値が重なる場合はその空間内で回転できる。
実装と未知セッションでの評価
完全版の中心部分は次のコードだ。
from common import make_dataset
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

data = make_dataset()
train = data["train"]
scaler = StandardScaler().fit(data["X"][train])
X = scaler.transform(data["X"])
pca = PCA(n_components=2, svd_solver="full").fit(X[train])
Z = pca.transform(X)
reconstruction = pca.inverse_transform(Z)
print(((X[~train] - reconstruction[~train]) ** 2).mean())
全スクリプトは保持次元を1から24まで変えて曲線を描く。展開したディレクトリでpython lesson02.py --output outputsを実行する。
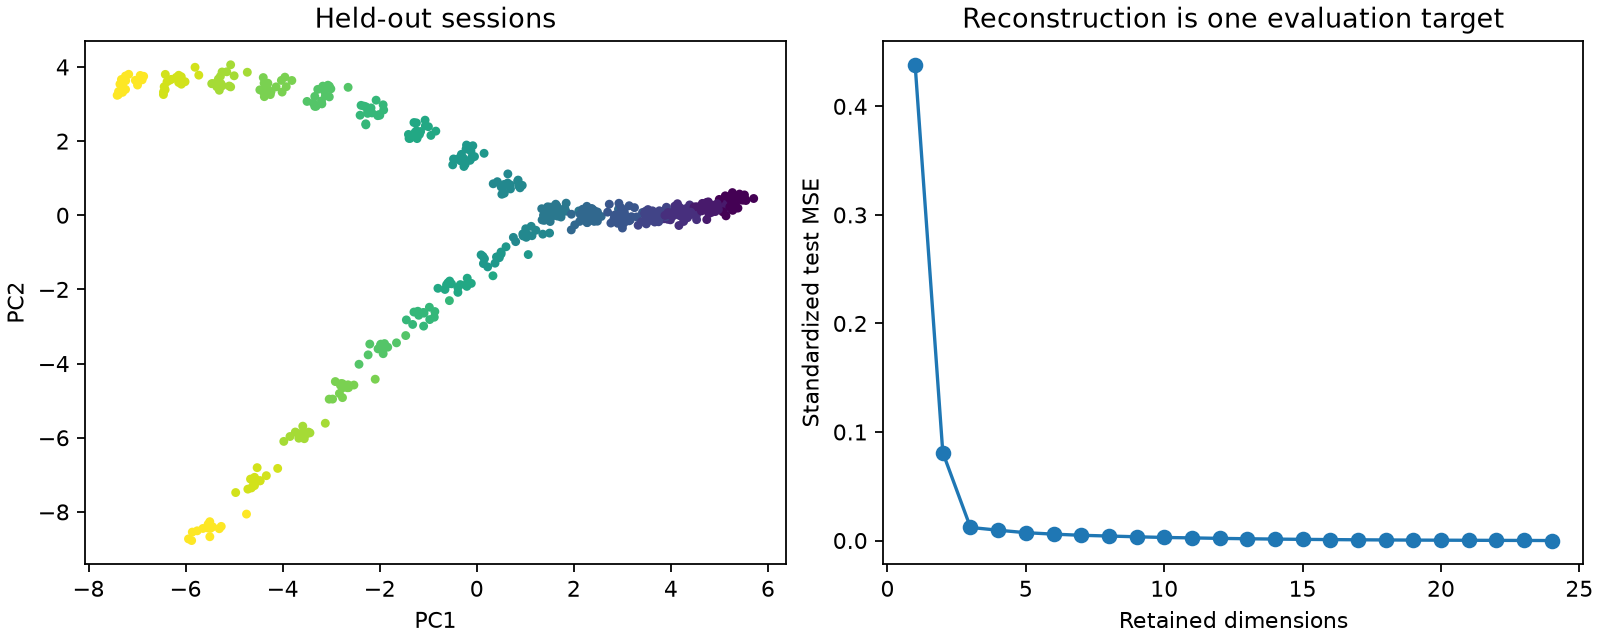
分割前に全データで標準化すると、評価分布の情報が学習へ漏れる。ラベルがなくても全行でPCAを適合すれば同様だ。本講義では学習セッションで座標系を固定し、新しいセッションを変換する帰納的評価を行う。
次元ごとの評価曲線は圧縮を理解する診断だ。本研究では、その曲線を繰り返し見てモデルを選んだデータを「未使用の最終テスト」と呼んではいけない。次元数は学習内部の交差検証か別の検証群で決め、最終手順をテスト群へ一度適用する。
誤差の単位も明記する。上のinverse_transformは標準化観測へ戻す操作だ。元の単位に戻すなら、続けてスケーラーの逆変換を使う。どちらの空間で計算したMSEかにより意味が変わる。
軸の解釈に必要なもの
遺伝子発現の大きな変動は分化かもしれないが、ライブラリサイズ、細胞周期、実験バッチかもしれない。PCAは科学的関心を知らない。カウントに適した前処理と実験情報を用意し、負荷量と独立したマーカーを確認する。滑らかに見えるだけでPC1を発達時間とは呼ばない。
会話では協力と対立を分ける軸が得られることもあれば、メッセージの長短を分けるだけかもしれない。大きな負荷量は線形軸への寄与を示すのであって、結果への因果効果を示すわけではない。窓と特徴スケールの選択は学習前から結果を変える。
PC3で分かれる枝は2D表示で重なるかもしれない。可視化次元とモデル次元は別に選ぶ。高い説明分散はこの目的での良い圧縮を示すが、予測に重要な情報を保存した保証ではない。
演習と確認
- 小例を検算する。 共分散行列を二つの単位方向に掛ける。答え: 固有値は7と1、保持割合は$0.875$、捨てた分散は1。
- 単位を変える。 一つの生特徴を100倍し、標準化あり・なしで比較する。ヒント: 生の共分散では影響が増す。標準化すれば符号や数値誤差を除き同じ結果になるはずだ。
- 小さいが決定的な特徴を考える。 結果が低分散軸だけに依存するなら95%の分散保持で十分か。答え: 不十分。表現の目的と予測の目的は違い得る。95%を万能基準とせず、適切な分割で後続タスクを評価する。
PCAは何を保存するかを正確に述べられるため強い基準となる。次回は復元を出発点にしつつ、線形の写像を非線形へ変える。