非線形エンコーダーは、PCAの平らな部分空間では表しにくい曲がったデータを圧縮できる。しかし、欲しい概念を自動で発見するわけではない。同じ観測にPCA、オートエンコーダー、変分オートエンコーダー(VAE)を学習して、両方を確かめる。
2D平面で点が曲がった帯に沿っているとする。一本の直線へ射影すると、帯に沿って遠い区間が重なる場合がある。非線形エンコーダーは帯に沿った座標を与え、デコーダーが元の観測へ戻すことができる。利点は写像の形を柔軟にしたことにあり、生物学や物語を理解した証拠ではない。
準備と90分の構成
PCAの復元と連鎖律を復習し、ニューラルネットの層と勾配降下の役割を理解しておこう。曲線の例15分、オートエンコーダー20分、VAEの確率25分、実習20分、診断10分で進める。復元性能と意味的な解釈を別欄にした比較表を提出する。
共通環境と実習一式を用意する。lesson03.pyにCPUで動くPyTorch実装がある。データもモデル重みも外部から取得しない。
二つの写像を一緒に学ぶ
エンコーダーは$z=f_\phi(x)$、デコーダーは$\hat x=g_\theta(z)$を計算する。24個の入力を二つの数に圧縮し、再び24個へ戻す。
$$ x\xrightarrow{f_\phi}z\xrightarrow{g_\theta}\hat x, \qquad \min_{\phi,\theta}\frac1n\sum_i\|x_i-g_\theta(f_\phi(x_i))\|_2^2. $$実習では各写像に32ユニットの隠れ層とTanhを使う。最終出力は線形だ。標準化特徴は負の値を取り得るため、出力を$[0,1]$へ制限するsigmoidは不適切になる。画像チュートリアルをコピーするのではなく、出力と観測モデルをデータに合わせる。
適切な容量の線形オートエンコーダーが二乗誤差の最適点に達すれば、PCA部分空間を表現できる。ただし潜在軸自体がPCA軸と一致する必要はない。非線形化は可能な復元を広げる一方、初期値依存、過学習、最適化の選択も持ち込む。HintonとSalakhutdinovの研究資料は歴史的背景を提供するが、今回の小さなモデルは当時の学習手順の再現ではなく教材だ。
復元に役立つ情報と関心のある状態は同じとは限らない。話者の特徴を保存すると復元しやすいなら、モデルは物語の進行より話者を優先し得る。復元目的だけでは、解釈可能な状態や因果的な状態が欲しいことは伝わらない。
VAEは点ではなく分布を出す
雑音のある観測を複数の状態が説明できる場合を考える。VAEのエンコーダーは一つのコードではなく分布を出す。
$$ q_\phi(z\mid x)=\mathcal N\!\left(\mu_\phi(x), \operatorname{diag}(\sigma_\phi^2(x))\right). $$事前分布を$p(z)=\mathcal N(0,I)$、観測モデルを$p_\theta(x\mid z)$とする。実習の観測モデルはデコーダー平均と固定標準偏差$s=0.3$のガウス分布だ。単位は標準化特徴の単位である。ネットワークが出すlogvarは潜在分布の分散の対数であり、観測雑音$s$とは別物だ。
VAEは証拠下限(ELBO)を最大化する。
$$ \mathcal L(x)=\mathbb E_{q_\phi(z\mid x)}[\log p_\theta(x\mid z)] -D_{\mathrm{KL}}\!\left(q_\phi(z\mid x)\|p(z)\right) \leq\log p_\theta(x). $$第1項は観測をよく説明するように促す。第2項は事前分布から離れることに費用を課す。KLは複雑な図へ適当に罰を与える量ではなく、二つの分布を比較する量だ。
下限になる理由は次の等式から分かる。
$$ \log p_\theta(x)=\mathcal L(x)+D_{\mathrm{KL}}(q_\phi(z\mid x)\|p_\theta(z\mid x)). $$後ろのKLは非負であり、近似事後分布とモデルの事後分布のずれが下限との隙間になる。KingmaとWellingの原論文が、この変分目的と勾配推定を展開している。
対角ガウス分布と標準正規分布のKLは解析的に書ける。
$$ D_{\mathrm{KL}}=\frac12\sum_j \left(\mu_j^2+\exp(\ell_j)-1-\ell_j\right),\qquad\ell_j=\log\sigma_j^2. $$$\mu=0$、$\ell=0$なら両分布は等しくKLは0だ。学習を始める前でも検算できる。
サンプリングを通して勾配を流す
$\epsilon\sim\mathcal N(0,I)$を引き、次のように書く。
$$ z=\mu+\exp(\ell/2)\odot\epsilon. $$乱数は$\epsilon$へ分離し、ネットワークの出力から標本までは微分可能な演算でつなぐ。これが再パラメータ化だ。完全版では学習時に標本をデコーダーへ入力する。パラメーターに依存しない定数を除いた、一観測当たりの最小化目的は
$$ \frac{\|x-\hat x\|^2}{2s^2}+D_{\mathrm{KL}} $$となる。特徴方向に和を取り、観測方向に平均する。一方だけ特徴平均に変えると相対的な重みが変わるので注意しよう。実習は固定観測雑音を持つ通常のELBOであり、説明なしにKL係数を変えたbeta-VAEではない。ただし$s$の選択自体は復元と事前分布のバランスを変える。
三つの表現を実行して読む
展開したディレクトリで実行する。
from common import make_dataset
from lesson03 import train_models

data = make_dataset()
embeddings, metrics = train_models(data, epochs=300)
for name, value in metrics.items():
    print(name, value)
図の保存にはpython lesson03.py --output outputsを使う。完全版には両モデル、正確な損失、固定シード、学習セッションだけで適合する標準化が含まれる。評価セッションは重みや前処理を変更しない。小さな全バッチ学習で各演算を読みやすくしているが、実運用ならミニバッチと検証データによる停止が一般的だ。
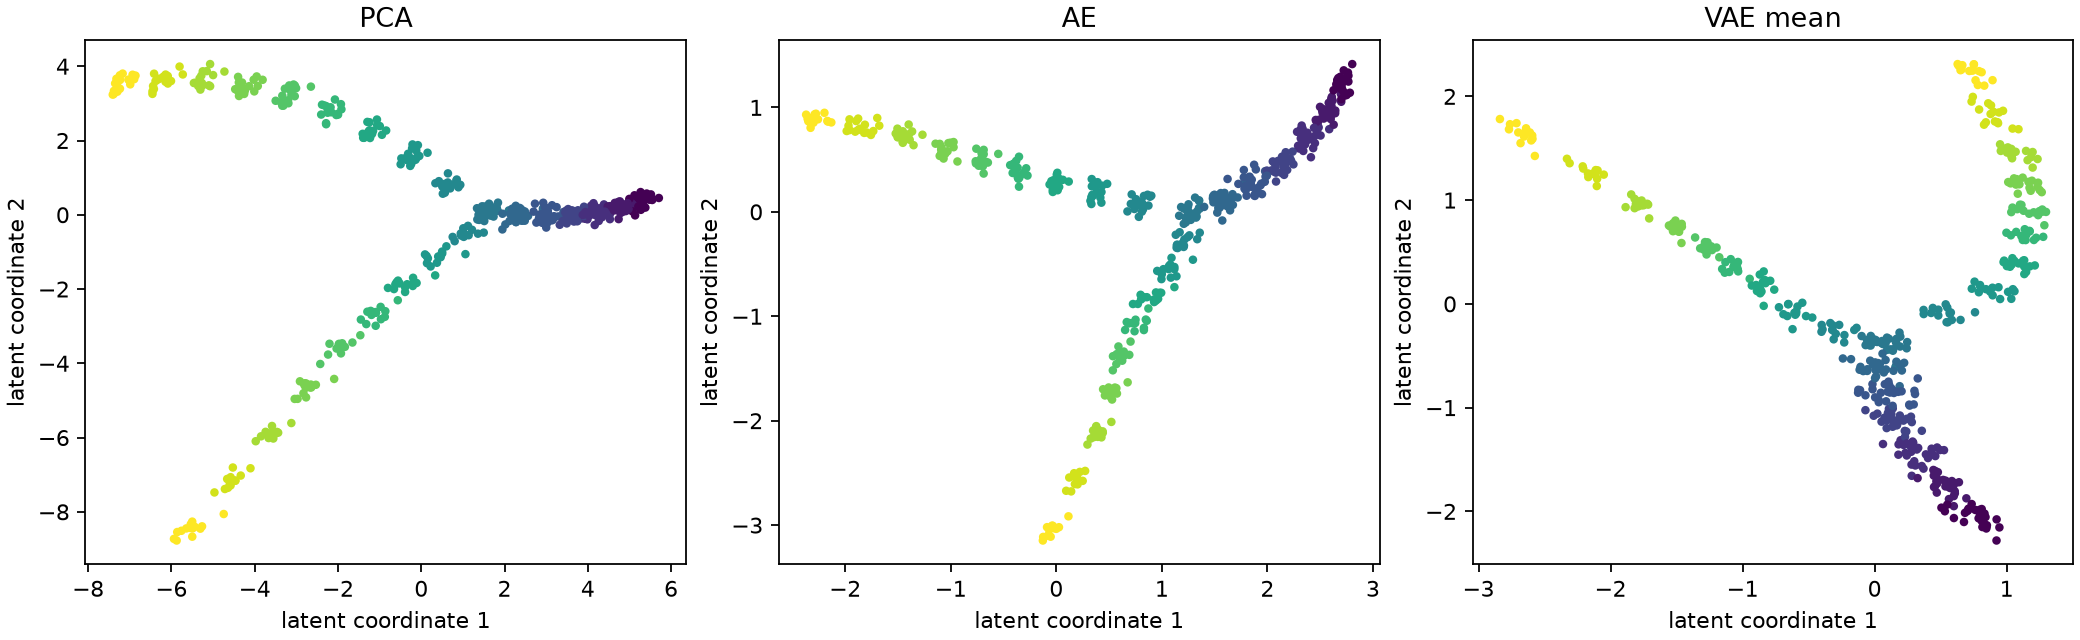
色は評価観測の記録時刻だ。時刻やz_trueで学習してはいない。VAEの図は事後平均を示す。vae_mean_decode_test_mseも$\mu(x)$を復号した誤差であり、ELBOの確率的な期待復元項とは違う。同じ量として報告すると、不確実性の意味を混同する。
低いMSEは一つの成果であり、状態表現の自動的な総合順位ではない。連続したステップが近くに残るか、未知セッションの分岐情報を読めるか、不要なメタデータが支配していないかを別に調べる。テスト結果を見て構造を調整した場合、最終報告には新たな未使用テストが必要だ。
生物学とキャラクター会話
遺伝子カウントにはガウス二乗誤差が合わないことがある。カウント用の尤度やライブラリサイズの扱いが重要になる。今回の合成特徴は観測モデルを単純に合わせるため連続値にしている。整った図だけでは細胞型や発達順序を検証できない。
会話埋め込みを復元するなら、保存するのはその埋め込みに既に含まれる情報だ。文脈窓に入っていない事件を復元目的だけで取り戻すことはできない。未来ターンや結果の予測で評価する場合も、予測時点で利用可能な情報だけを使い、利用者やキャラクターが変わる条件で確認する。
潜在サンプリングは物語の不確実性が較正された保証ではない。分布が変わればVAEも誤り、滑らかな事前分布は中間状態の意味を保証しない。教師なし軸を意味因子として一意に定めるには追加仮定が必要であり、Locatelloらの分析がこの制限を扱う。
演習と解説
- ボトルネックを広げる。 潜在次元を24にして学習MSEが改善しても、状態発見の改善とは限らない理由は。答え: 観測と雑音をコピーする余裕が増える。未知セッションの後続タスクも評価する。
- KLを計算する。 一座標で$\mu=1$、$\sigma^2=1$なら標準正規分布へのKLはいくつか。答え: $1/2$。$\mu=0$、$\sigma^2=1$なら0。
- 観測雑音を変える。 検証群で$s=0.15$と$s=0.6$を比較する。ヒント: 小さい$s$は復元項を強める。MSEとKLを併記し、どちらも意味的有用性そのものではないと説明する。
次回は個々の観測を復元する問題から、曲がった空間の近傍関係を保存する問題へ進む。