周囲の空間で近い二点が、データの載る曲面に沿っては遠い場合がある。多様体学習は信頼できる局所接続を決め、その接続から全体像を作る。
紙を巻いたSwiss rollを想像しよう。隣り合う層の点は空中の直線距離では近い。しかし紙から離れず歩くなら、巻きを長く回る必要がある。直線距離と曲面距離は別の問いに答える。
準備と90分の構成
PCA、点間距離、グラフの頂点と辺を復習する。巻いた紙15分、近傍グラフ20分、Isomap20分、UMAP15分、実習と診断20分で進める。観測空間の次元、内在次元、表示次元を区別するのが目標だ。
共通環境、実習一式、lesson04.pyを使う。scikit-learnに加えてumap-learnが必要だ。UMAPの初回実行は数値ルーチンのローカルコンパイルで時間がかかることがある。
曲面は曲線ではない
標準的なSwiss rollは次で表せる。
$$ x(u,v)=(u\cos u,\ v,\ u\sin u). $$観測は三座標だが、自由に変わるパラメーターは$u$と$v$の二つだ。内在次元は2であり、展開すれば二次元の紙になる。一本の時間軸ではない。紙の上に一本のらせんだけを描けば、それは別の一次元データだ。
$(u,v)$自体が距離を保存するとは限らない。$u$に沿う移動の速さは$\sqrt{1+u^2}$だから、弧長座標にはこの積分が必要になる。このため、うまく展開した図の横軸が生成器の$u$値と一致する必要はない。
多様体仮説は、高次元観測が低次元構造の近くへ集まるという仮定であり、すべてのデータに対する保証ではない。分岐点、分離した集団、急変、混合は一枚の滑らかな曲面では説明しにくい。共通の分岐データも、一つの滑らかな座標系よりグラフが適する場合を思い出させる。
まず局所グラフを作る
選んだ特徴距離で各点の近い$k$点を探し、ユークリッド距離を重みにして辺を張る。$j$が$i$の近傍でも逆は保証されないので対称化する。実習ではどちらか一方が選べば接続する。
$$ d_G(i,j)=\min_{\pi:i\leadsto j}\sum_{(a,b)\in\pi}\|x_a-x_b\|_2. $$標本が十分に密で辺が局所にとどまるとき、この最短経路距離が曲面上の測地距離を近似する。アルゴリズムが数値を返しただけでは良い近似にならない。
$k$が小さすぎるとグラフが切れたり疎な領域が分断されたりする。大きすぎるとSwiss rollの層をまたぐ近道や、本来別の枝をつなぐ辺ができる。標準化、雑音、標本密度も影響する。連結成分を確認し、妥当な近傍範囲で結論が変わらないか調べよう。
Isomapはグラフ距離を保存する
Isomapは近傍グラフを作り、学習点間の最短経路を計算し、古典的多次元尺度法で低次元へ配置する。グラフ距離行列を$D_G$、中心化行列を$H=I-\mathbf1\mathbf1^\top/n$とすると
$$ B=-\frac12H(D_G\odot D_G)H $$を作る。正確なユークリッド距離なら$B$は中心化されたグラム行列だ。上位の正の固有値と固有ベクトルから$Y=V_d\Lambda_d^{1/2}$を得る。推定した測地距離では近似になり、負の固有値が現れることもある。PCAと同じ固有ベクトルの操作を使うが、分解する行列が変わった。
局所から全体の幾何を構成する考えはTenenbaum、de Silva、Langfordの原論文にある。新しい点の変換など実装上の挙動はscikit-learnの説明を参照する。
全点対の距離行列は、標本が増えると大量のメモリを要する。Isomapは今回の小さな診断に適するが、数百万の細胞や会話窓に厳密な全点対距離を計算するのが標準の選択ではない。
UMAPは重み付き近傍構造を配置する
UMAPも近傍から始めるが、Isomapの全最短経路距離行列を再現する目的ではない。局所スケールを調整した近傍の所属度を作り、グラフに結合し、それを反映する低次元配置を最適化する。引力と斥力の項が配置を形作る。正式な構成はUMAP原論文にある。
n_neighborsは考慮する近傍の範囲を変え、min_distは出力で点がどれほど密に集まれるかへ影響する。したがって島の幅や島間の余白は表示設定で変わる。図の隙間を生物学的障壁や物語変化の所要時間へ置き換えてはいけない。
UMAPは探索に役立つ一方、大域距離、密度、軸の意味を歪め得る。時間の矢印も与えない。既知時刻で色を付けるのは診断であり、座標を時計にする操作ではない。後続の経路解析では、用いる空間とグラフを正当化する必要がある。表示上の点を見た目で結ぶだけでは足りない。
二部構成の実験
展開した実習ディレクトリで実行する。
from common import make_dataset
from lesson04 import fit_manifolds

data = make_dataset()
embeddings, metrics = fit_manifolds(data)
print(metrics)
関数は学習セッションだけで標準化し、学習グラフの連結性を確認する。その後、学習観測でIsomapとUMAPを適合し、未知セッションを変換する。共通データでは30近傍を使う。生成器の座標や時刻ラベルは学習に入らない。
python lesson04.py --output outputsでは別のSwiss roll診断も行い、図を保存する。この診断は800点すべてで適合する。幾何の教材であり、未知セッションへの一般化実験ではない。連結性もセッション実験とは分けて報告する。
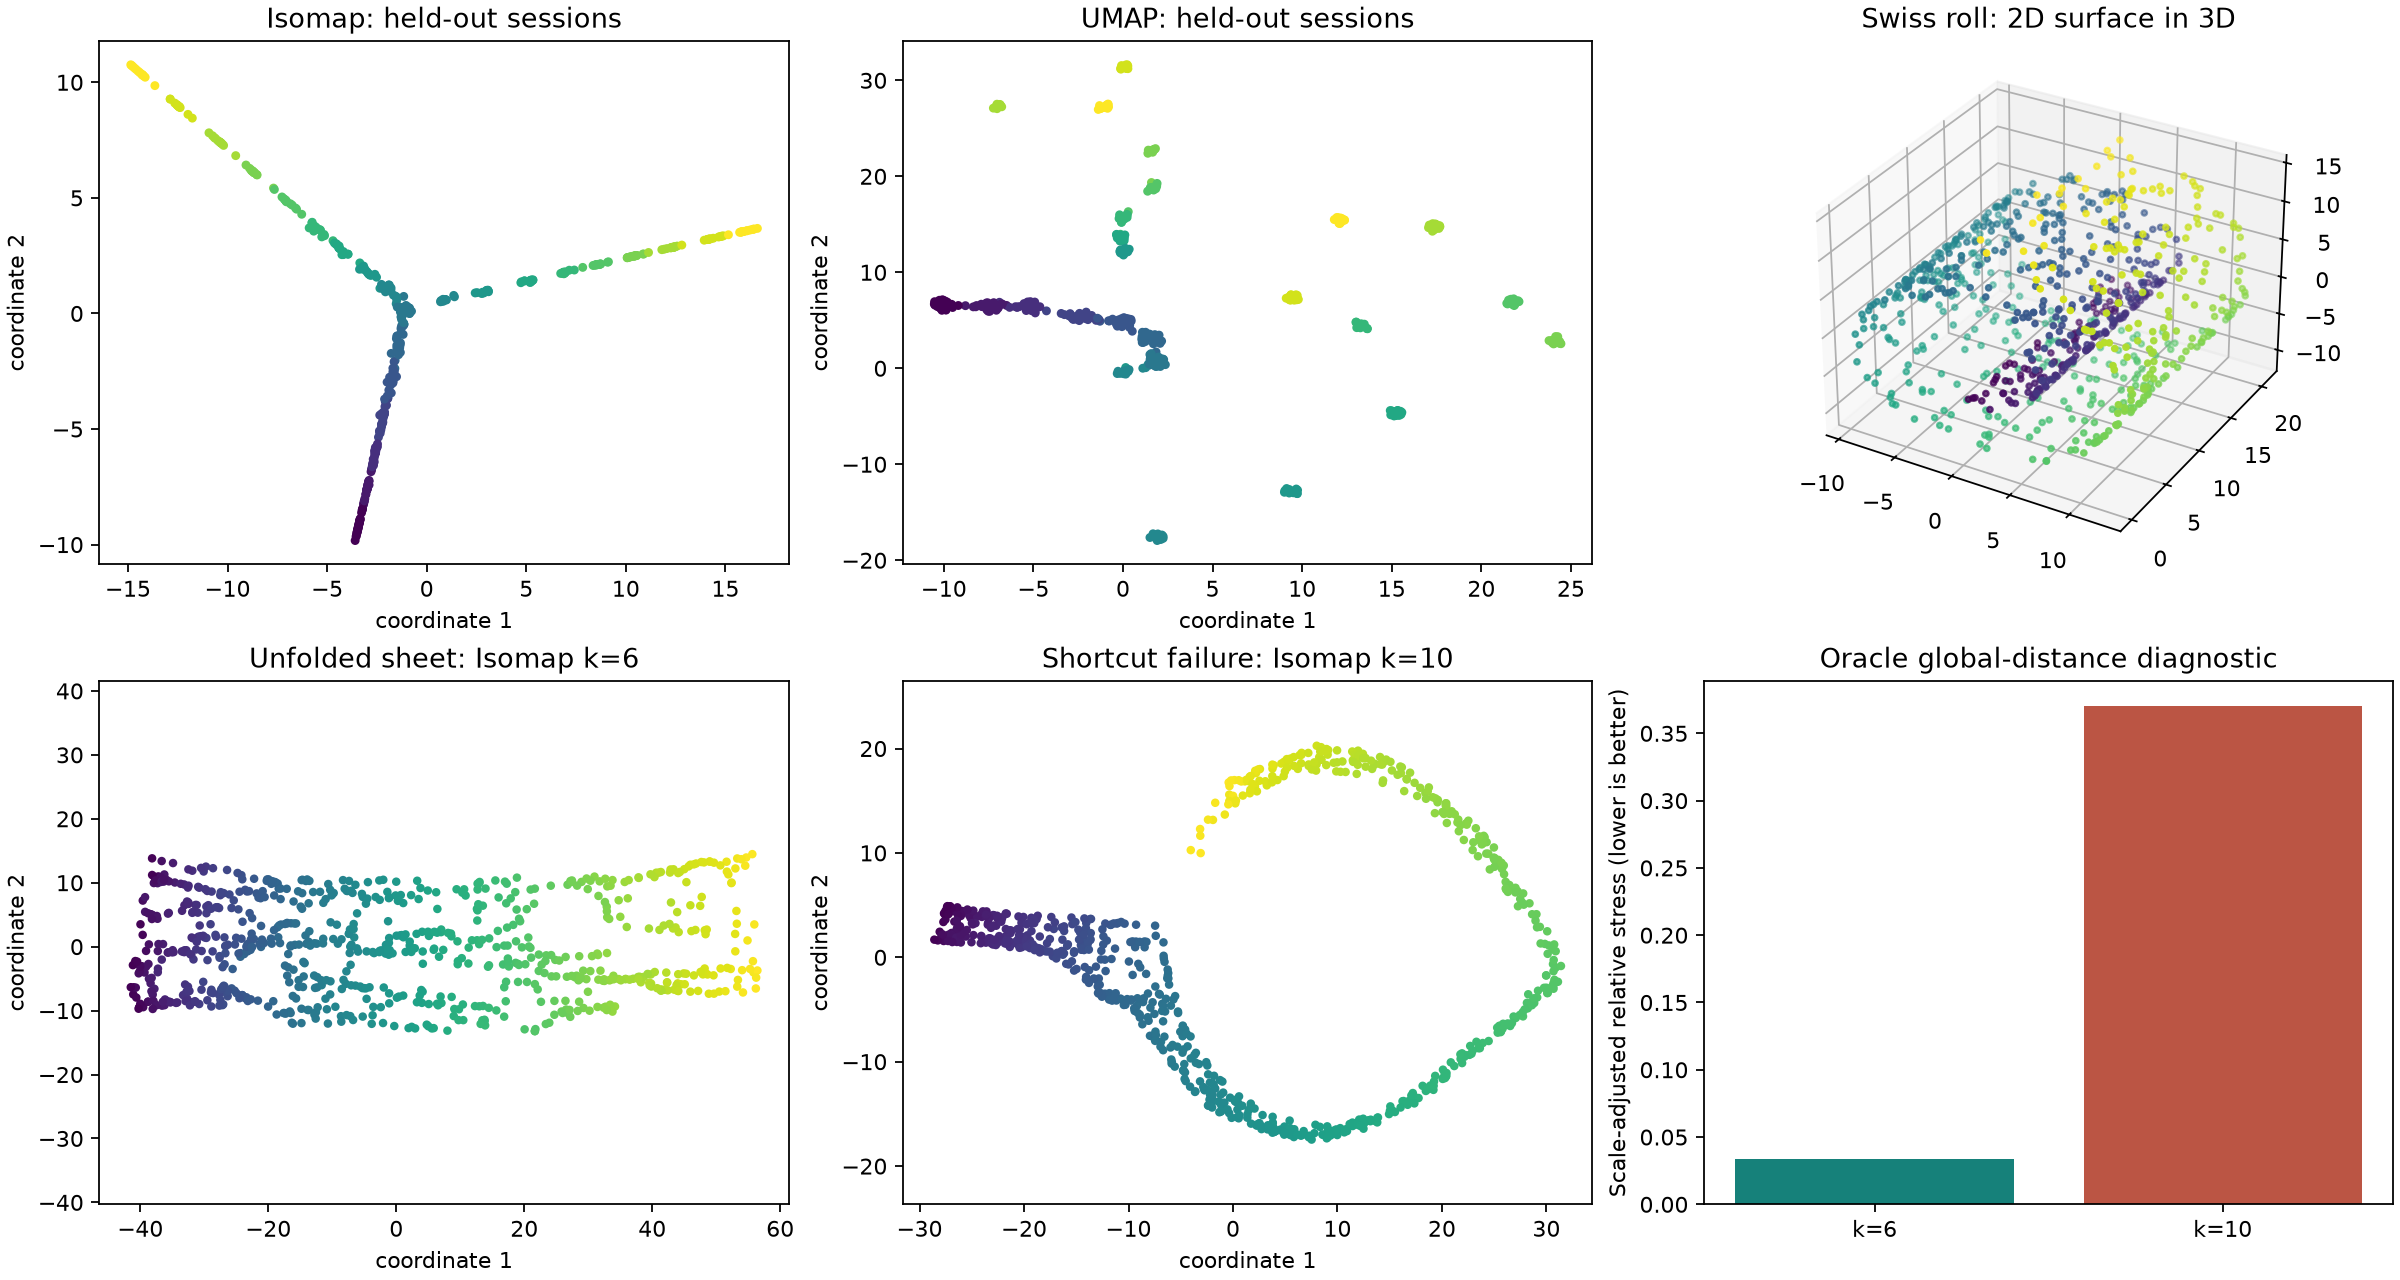
固定シードのSwiss roll実験では、どちらも連結な二つのグラフを比較する。6近傍では紙が展開され、10近傍では曲面に沿って遠い部分を結ぶ5本の辺が近道を作る。既知の内在距離が観測距離の2倍を超える辺を検出する。これは正解を知る合成例の診断であり、未知の実データにそのまま適用できる規則ではない。
最後の図はスケール調整後の距離誤差 $\min_{a>0}\sqrt{\sum_{i 共通データでは10近傍のtrustworthinessを計算する。元の特徴空間で遠いのに埋め込みで近くなった点へ罰を与える指標だ。高ければ、こうした局所的な偽近傍が比較的少ない。しかし大域距離、時間方向、元の距離の科学的妥当性は保証しない。今回のUMAPは約0.993でも、共通経路を分断された島のように表示する。良い局所近傍と誤解を招く全体配置は両立する。近傍再現率、連結性、設定感度、独立したラベルも確認する。 細胞状態の滑らかな曲線は分化かもしれないし、技術的な勾配かもしれない。独立した生物学的マーカーとともに、ドナーやバッチのラベルも見る。空白は不可能な遷移ではなく標本不足かもしれない。UMAPの島の位置だけから系譜を推定しない。 会話の意味的近傍は異なる時点を結び得る。二度の謝罪が、違う事件の前後に起こることもある。問いたい遷移に十分な履歴を状態へ含める必要がある。連続ターンの辺と意味類似の辺を別に見る。時間的な隣接と意味的な隣接は同じとは限らない。 局所幾何を確かめてから全体構造を主張する。この順序が再利用できる教訓だ。次回は近傍グラフ上のランダムウォークから、局所遷移の反復が示す構造を学ぶ。二分野での確認事項
演習と解説