Diffusion Mapは、異なる観測から出発するランダムウォークが似た場所に到達するとき、その観測を近くに配置します。局所的な接続から全体の座標を作る方法です。この講義の遷移行列はデータを探索する規則であり、細胞や会話の実際の移動記録ではありません。
前提知識: PCAの固有ベクトル、距離、条件付き確率、第4講のkNNグラフ。90分: 直感と例15分、行列20分、スペクトル座標20分、Python25分、解釈10分。目標は、遷移行列と定常分布を計算し、diffusion stepと実時間を区別することです。
共通の環境とデータ仕様を確認してください。lesson05.pyは実習一式の中で実行します。
1. 曲がった道を歩く
平面にU字形の点群を描きます。両端は直線距離では近くても、近傍だけを歩くには底を回る必要があります。両端の歩行者が一歩で到達できる場所は異なりますが、多数の歩数の後には両者ともU全体を探索できます。
まず、単位重みの辺で結ばれたA–B–Cを考えます。Aからは必ずBへ進み、BからはAとCへ半分ずつ進みます。
$$P_0=\begin{pmatrix}0&1&0\\1/2&0&1/2\\0&1&0\end{pmatrix}.$$Bには辺が2本あるため、長期的には訪問が多くなります。定常分布は$(1/4,1/2,1/4)$であり、一様分布ではありません。また、このグラフには奇数歩と偶数歩で訪問先が交互に変わる周期性があります。確率1/2でその場に留まるlazy walkを使えば、この周期性を避けられます。
2. 類似度を確率へ変える
スケーリングとPCAを通した観測を$r_i$とします。一方が他方の$k$近傍に入れば辺を張り、
$$W_{ij}=\exp(-\|r_i-r_j\|^2/\sigma^2),\qquad W_{ii}=0$$とします。大きい重みほど強い類似性を意味します。実装では有向近傍の重みの最大値を使い、$W$を対称化します。
$$d_i=\sum_jW_{ij},\quad D=\operatorname{diag}(d_i),\quad P_0=D^{-1}W,\quad P=\tfrac12(I+P_0).$$各行の和は1です。連結なグラフなら、定常分布は一意に$\pi_i=d_i/\sum_jd_j$となります。詳細釣り合い$\pi_iP_{ij}=\pi_jP_{ji}$も成り立ちます。これは構成したウォークの可逆性であり、細胞分化が可逆だという主張ではありません。
非連結なグラフでは成分間を移動できず、固有値1の固有ベクトルが複数あります。各成分の定常分布を混ぜる比率も一意ではありません。孤立点では次数が0で割り算ができません。座標を見る前に連結成分を調べる必要があります。
3. Laplacianと遅い座標
組合せLaplacianは$L=D-W$です。各点に値$f_i$を置くと、
$$f^TLf=\frac12\sum_{ij}W_{ij}(f_i-f_j)^2$$となります。強くつながった点の値が似ていれば、この量は小さくなります。小さい固有値の固有ベクトルがグラフ上で滑らかな変化を表す理由です。
対称正規化Laplacianは
$$L_{\rm sym}=I-D^{-1/2}WD^{-1/2}$$です。$L$とは異なり、次数の正規化によって問題が変わります。実習ではlazy walkに対応する対称行列$S=I-L_{\rm sym}/2$を解きます。$Su_\ell=\lambda_\ell u_\ell$なら、
$$\psi_\ell(i)=u_\ell(i)/\sqrt{\pi_i}$$が$P$の右固有ベクトルになります。このスケーリングにより、定常分布で重み付けした内積で正規直交します。
定数に対応する固有値$\lambda_0=1$を除き、
$$\Phi_t(i)=\big(\lambda_1^t\psi_1(i),\ldots,\lambda_m^t\psi_m(i)\big)$$を座標にします。小さい固有値の成分は速く減衰します。$t$を大きくするとゆっくり混ざる構造が目立ちますが、細部も失われます。この構成と複数スケールの解釈はDiffusion Mapsの原論文で展開されています。
近似する距離は
$$D_t^2(i,j)=\sum_k\frac{(P^t_{ik}-P^t_{jk})^2}{\pi_k}$$です。出発点が違っても、到着先の分布が似ていれば近くなります。連結で可逆なウォークの全非定数固有ベクトルを使えば、この量はdiffusion座標のユークリッド距離の二乗と一致します。2軸だけ使う場合は近似です。$P^t$の行に通常のユークリッド距離を適用すると、定常分布の重みを落としてしまいます。
4. Python: 確率を検証してから描く
全スクリプトは疎行列で類似度を作り、eigshで$S$を解きます。以下は展開した実習フォルダで実行する、ダウンロード版と共通の中核計算です。
from common import make_dataset, prepare_embedding
from lesson05 import affinity_graph, diffusion_coordinates
import numpy as np

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
W = affinity_graph(Z, k=48)
Dmap, values, P, pi, components = diffusion_coordinates(W, time=4)
print(components, values)
print(np.max(np.abs(np.asarray(P.sum(axis=1)).ravel() - 1)))
print(np.max(np.abs(np.asarray(pi @ P).ravel() - pi)))
python lesson05.py --output outputsを実行します。JSONの行和誤差と定常分布誤差は丸め誤差程度になるはずです。PNGではPCAの最初の2軸とdiffusion座標を比べます。時間による着色は計算後の解釈用で、グラフ作成には使用しません。
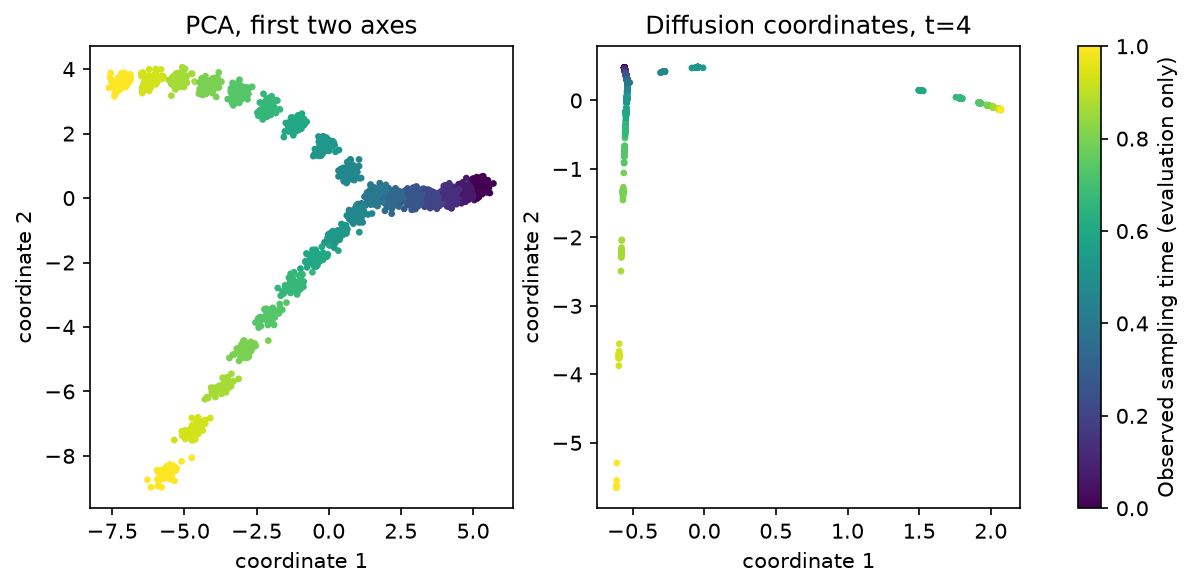
スケーラーとPCAは学習セッションだけに適合します。ただし、グラフには評価セッションも入るため、これは全観測を一緒に扱うtransductiveな探索です。未知セッションの未来予測を評価したものではありません。新しい点への拡張には別の規則と評価設計が必要です。
5. 細胞とキャラクター会話
細胞では、適切に前処理した発現量の近傍が分化の連続構造を示すことがあります。一方、ライブラリサイズ、バッチ効果、標本密度が近傍を支配することもあります。Diffusion Mapだけでこれらが消えるわけではありません。密度を正規化するカーネルは追加のモデル選択です。
会話では、共通のエンコーダーと比較可能な長さの窓を使います。関係の緊張や物語の段階が近傍に現れるかもしれません。しかし、グラフの一歩は別ユーザーのセッションへ移ることもあります。実際の次ターン遷移は、第8講でセッション内の順序から推定します。
共通データは$k=24$で4成分、$k=48$で1成分になります。実習は明示的に48を選び、非連結なら全体のdiffusion mapを拒否します。暗黙に橋を追加しません。この感度は調査対象であり、大きい$k$が正しいという証明ではありません。
$k$、帯域幅、diffusion timeを一緒に変えます。近傍が少なすぎれば連続体が分断され、多すぎれば近道ができます。美しい分岐の図には、設定変更に対する安定性と独立した分野の根拠が必要です。
6. 演習と解答
- Aからのlazy walkを計算してください。 Aに1/2留まり、Bに1/2移動します。定常分布は$(1/4,1/2,1/4)$のままです。
- $t=1,4,16$では何が変わりますか。 各軸に対応する固有値のべきが掛かり、速い成分から縮みます。実時間の情報が追加されるわけではありません。
- 発達の方向を逆にすると、このグラフは変わりますか。 点と距離が同じなら変わりません。対称類似度には方向がなく、初期状態や順序の測定などが必要です。
次回は同じ近傍グラフを使い、区別すると役立つ状態の集団を探します。