Clusteringは複雑な観測を少数の状態名で扱えるようにします。しかし、自然や物語にちょうどその数の状態が存在すると証明するものではありません。連続的なtrajectoryにも便利な区間を設けられます。境界が自然に鋭く存在する必要はありません。
前提知識: PCA、距離、第5講の重み付きグラフ。90分: 例15分、幾何的手法20分、modularityとcommunity detection20分、Python25分、解釈10分。目標は分割の仮定を説明し、設定への感度を調べ、集団の発見と意味付けを区別することです。
共通の実習案内、lesson06.py、実習一式を使います。lesson05.pyのグラフ関数も必要です。
1. 同じ点にも違う分け方がある
2次元平面に密な点群を二つ置き、まばらな点の橋で結びます。最も近い中心を選ぶ方法は、平面の中央付近に境界を作ります。密度を見る方法は橋をnoiseとするかもしれません。グラフの方法は、集団内部の接続が期待より強いかを調べます。質問が違うため、結果が違っても直ちに実装ミスとは言えません。
二つの点群を三日月形に変えると、中心に基づく境界は三日月を切ることがあります。局所接続なら曲線をたどれます。反対に、一つの滑らかな弧を六つに分けるよう指定すれば、生成過程に六種類のカテゴリがなくても六つのラベルが得られます。
アルゴリズムの選択は、どのような集団を探したいかの選択です。実習を比較するときも、この三つの場面を思い出してください。
2. 距離と密度による四つの見方
k-meansは$K$個の中心と割り当てについて、
$$\min_{c,\mu}\sum_i\|r_i-\mu_{c_i}\|^2$$を小さくします。近い中心へ割り当て、中心を所属点の平均へ更新する操作を繰り返します。目的関数は増えませんが、初期値によって異なる局所解に到達します。複数初期化が役立ちます。大きな尺度の特徴が距離を支配するので、スケーリングも必要です。中心の周囲に集まる集団に向き、新しい点も最近中心へ割り当てられます。
階層的クラスタリングは一つずつの点から始め、集団を併合します。何を併合するかをlinkageが決めます。Ward linkageは群内二乗誤差の増加が最小の併合を選びます。Single linkageは最近点対を見るため、細い橋に沿って集団を連結することがあります。Dendrogramは入れ子の分割を示しますが、どの高さで切るかは選択です。
DBSCANは半径$\varepsilon$内に十分な観測がある点をcoreとします。密度で接続するcoreが集団を作り、近くのborder pointが加わり、残りにnoiseラベル-1を付けます。半径と最小標本数が主な設定です。集団によって密度が大きく違うと、一つの半径では説明しにくくなります。
HDBSCANは複数の密度尺度の階層を調べ、持続するクラスタを取り出します。最小クラスタサイズなどは依然として指定し、noiseも許します。一つの半径への依存を減らしますが、設定不要ではありません。scikit-learnのガイドで各手法の目的と実装を確認できます。基本実習はDBSCANを実行し、HDBSCANは発展課題にします。
3. Modularityは予想以上の接続を見る
対称類似度行列$W$を再利用します。$d_i=\sum_jW_{ij}$、$2m=\sum_i d_i$とすると、ラベル$c_i$に対するmodularityは
$$Q=\frac{1}{2m}\sum_{ij}\left(W_{ij}-\gamma\frac{d_id_j}{2m}\right)\mathbf1[c_i=c_j]$$です。最初の項は観測された内部接続、次の項は次数に基づくnull modelで期待される接続です。Resolution $\gamma$を増やすと一般に小さい集団が選ばれやすくなりますが、特定の個数を保証しません。
弱い辺一本でつながった二つの三角形を考えます。各三角形には強い内部接続が三本あります。全体が連結でも、二つに分けると内部重みが期待を超える場合があります。次数が多い点は元々よく接続するため、次数補正が必要です。
Modularityには解像度の限界があり、同程度に高い値を持つ分割も複数あります。特定グラフの得点が高くても、生物学的に正しいとは限りません。Resolutionを変えると目的関数も変わるため、異なる設定の値を同一尺度として比較しないでください。
4. LouvainとLeiden
Louvainは小さなcommunityから始め、目的関数が改善するよう点を移動します。その後、communityを大きなノードへ集約して繰り返します。効率的なヒューリスティックであり、大域最適化ではありません。重みとresolutionの扱いはNetworkXの文書で確認できます。
Louvainは内部接続が弱い、あるいは非連結のcommunityを返すことがあります。Leidenは集約前にrefinementを追加し、アルゴリズムと目的関数の条件の下でより強い接続性を保証します。すべての解像度問題を解決したり、大域最適な分割を認定したりするわけではありません。Leiden論文は一回の反復、安定した反復、収束後の保証を区別します。本実習は依存を軽くするためLouvainを実行し、結果をLeidenとは呼びません。
5. Pythonで比較と感度確認
全スクリプトはPCAの6軸を使って、k-means、Ward、DBSCAN、Louvainを実行します。図は最初の2軸なので、重なって見える点も残りの軸では分かれている可能性があります。
from common import make_dataset, prepare_embedding
from lesson05 import affinity_graph
from lesson06 import community_labels
import networkx as nx
from sklearn.metrics import adjusted_rand_score

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
G = nx.from_scipy_sparse_array(affinity_graph(Z))
labels, groups = community_labels(G, resolution=1.0)
finer, _ = community_labels(G, resolution=2.0)
print(len(groups), adjusted_rand_score(labels, finer))
python lesson06.py --output outputsを実行します。Adjusted Rand index、ARIは偶然の一致を補正した分割間の一致度です。意味を持つラベル名は不要です。ここでは正解との一致ではなく、resolutionに対する感度を測ります。
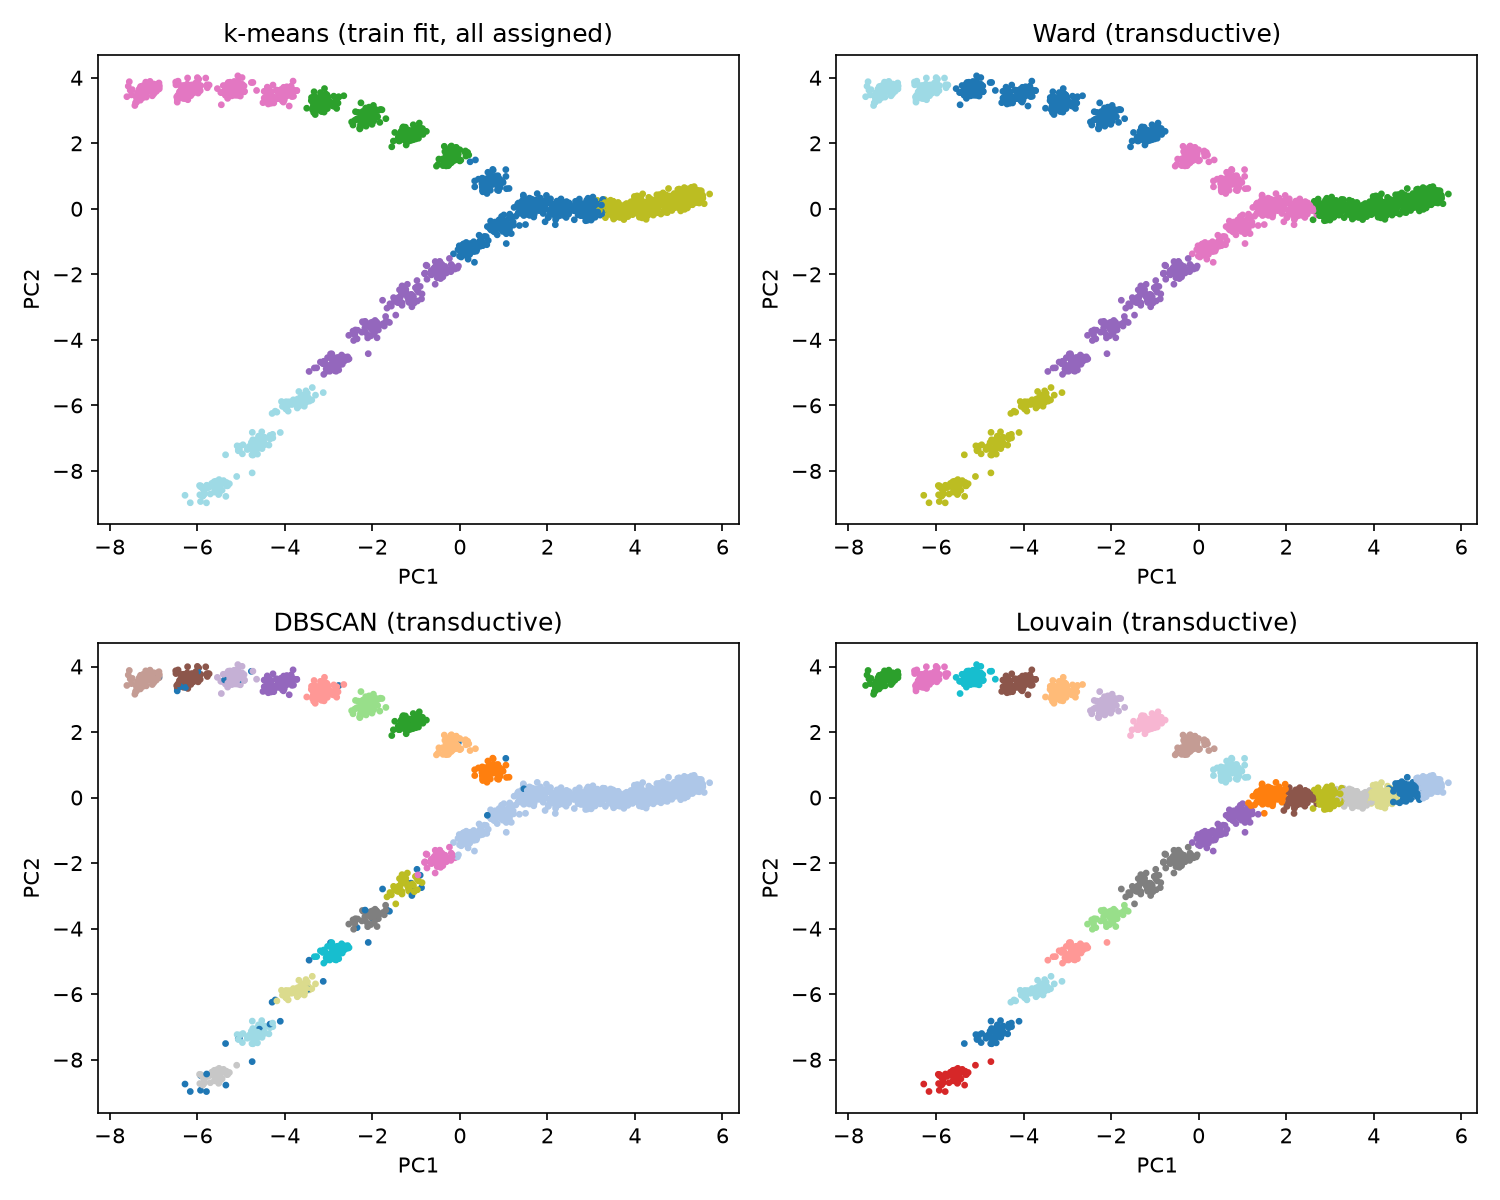
スケーラー、PCA、k-meansの中心は学習セッションだけから求めます。評価セッションの中心までの二乗距離は幾何的な診断です。Ward、DBSCAN、Louvainは全観測を見るtransductive解析であり、図の見栄えは未知データの分類精度ではありません。乱数seed、近傍数、セッション単位の再標本化を変え、境界の安定性を調べます。
6. 細胞状態と物語状態の命名
細胞ではmarker発現、batch構成、他のdonorでの再現を調べてから命名します。特定batchにだけ存在する集団は測定過程の差かもしれません。既知のcell type間も連続的に移ることがあり、硬い境界は便利な近似にすぎない場合があります。
キャラクター会話では、各集団から会話窓を標本化し、明示した基準でannotationします。「信頼形成」「対立の激化」という名前にはテキストの根拠が必要です。話者、言語、窓の長さが分割を説明する可能性もあります。クラスタ名はユーザーの内面の心理診断ではありません。
授業では合成データまたは利用に同意された会話を使います。同じユーザーやセッションを学習と評価に分けず、オンライン予測を目指す場合は未来のターンを読むエンコーダーを使わないでください。
7. 演習とヒント
- DBSCANのnoiseは悪いデータですか。 選択した密度基準に合わないという意味です。珍しい遷移は重要かもしれず、削除前に調べます。
- Resolutionを増やして状態数が倍になれば、どちらが正しいですか。 個数だけでは決まりません。安定性、利用目的、独立したannotationを比べます。Resolutionは質問を変えます。
- 「対立」communityの検証を設計してください。 その集団と条件を合わせた他集団の窓を、ラベルを隠してannotationします。一致度と言語・キャラクターなどの交絡要因を報告し、都合のよい例だけを選びません。
次回は領域を経路へ変え、それをtrajectoryと呼ぶための仮定を考えます。