観測の間に描いた経路は、進行についての幾何的な仮説です。細胞の発達や物語の変化と解釈するには、始点を定め、分岐を検証し、その順序を支持する根拠を示す必要があります。Snapshotの形だけから時計や因果方向は得られません。
前提知識: PCA、近傍グラフ、clustering、最短経路。90分: 分岐例15分、MST15分、principal curveとgraph20分、PAGA15分、実習と解釈25分。目標は、最小の木、適合した曲線、集団間接続グラフ、実際の時系列を区別することです。
共通の環境、lesson07.py、実習一式を使います。
1. 一つの幹から二つの続きへ
平面に水平の点列を描き、その先を上下に分けてY字形にします。収集順序を隠すと、clusteringは領域を示しても、どの領域がつながるか、どこが始まりかは分かりません。
少数の代表点を結ぶ木は、明確な出発点になります。候補となる分岐を示しますが、各個体が実際に通った道を復元したとは主張しません。図にループを加えると限界も分かります。木は必ずどこかの接続を切ります。どの方法にもtopologyの仮定があります。
共通データには複数stepで観測した分岐セッションがあります。本講では適合中にセッション内部の遷移を意図的に隠します。点の幾何からbaselineを作り、残しておいた観測時間で診断します。実際の順序は第8講で使います。
2. Minimum Spanning Tree
代表点$\mu_1,\ldots,\mu_K$間の費用を
$$w_{ab}=\|\mu_a-\mu_b\|_2$$とし、全代表点を結ぶ木のうち総費用が最小のものを選びます。
$$T^*=\arg\min_T\sum_{(a,b)\in T}w_{ab}.$$木には辺が$K-1$本あり、閉路がなく、任意の2点間の経路が一つです。Kruskal法は費用順に辺を見て、閉路を作らない辺だけ追加します。学部のグラフアルゴリズムがMLの経路推定へつながります。
ここで重みは距離であり、類似度ではありません。類似度の和を最小化すると弱い接続を優先します。疎な近傍グラフから始める場合も辺の長さを使います。非連結なら一つの木ではなくforestになります。SciPyのグラフ関数にはMSTと最短経路があります。
雑音を含む全点で木を作ると、外れ値を追うことがあります。実習では学習セッションのk-meansで14代表点を求め、その完全ユークリッドグラフにMSTを作ります。完全グラフは木を保証しますが、大きい空白を無理に結ぶこともあります。特に長い辺は、確立した遷移として扱う前に調査します。
3. Principal curveとprincipal graph
Principal curveは、PCAの直線を分布の中央を通る滑らかな曲線へ拡張します。曲線を$f(s)$、観測$x$に最も近い曲線上の位置を$s_f(x)$とすると、古典的な自己整合条件は
$$f(s)=\mathbb E[X\mid s_f(X)=s]$$です。同じ曲線位置へ射影される観測の平均が、その位置に一致するという意味です。
直感的には、現在の曲線への射影と、射影位置に応じた観測の平滑化を交互に行います。平滑化を制御しなければ、曲線が雑音を一つずつ拾います。自己整合性は真の発達経路や解の一意性を保証しません。HastieとStuetzleの原論文で古典的な定義を確認できます。
分岐しない曲線一本ではY字形を表せません。Principal graphは分岐点を持つ頂点と辺へ表現を拡張します。授業では次の目的を考えられます。
$$\sum_i d(r_i,G)^2+\lambda\,\operatorname{length}(G)+\eta\,\operatorname{complexity}(G).$$データへの近さと、長すぎず複雑すぎない構造を両立させます。これは説明用の模式的な目的であり、すべてのprincipal graphの公式ではありません。実際の方法は弾性、平滑化、topology変更、正則化が異なります。分岐を増やせば雑音にも適合するので、複雑度の制御が重要です。ダウンロード実習はMST baselineであり、principal curveやelastic graphの実装ではありません。
4. PAGAは集団間の接続を要約する
PAGAは観測の近傍グラフと、その頂点の分割から始めます。集団ごとに粗いノードを作り、集団間接続の証拠を無作為接続の期待と比べて重みにします。弱い接続は除外できます。
重要なのは、異なる集団の観測間に実在する近傍辺です。クラスタ中心間の距離だけではありません。PAGAは非連結構造や木ではないtopologyを残せます。MSTは入力が連結なら木を強制します。中心点MSTをPAGAと呼ぶと、アルゴリズムも解釈も変わってしまいます。
PAGA原論文は接続強度の統計的な構成と、粗い経路を細胞単位の距離に組み合わせる方法を説明します。Topologyを調べる道具であり、すべての辺が実際のlineageだという証明ではありません。クラスタの粒度と近傍構成は結果に影響します。
5. Pseudotimeにはrootが必要
始点$r$と長さで重み付けしたグラフ$G$に対し、基本的なpseudotimeは
$$\tau_i=d_G(r,i)$$です。同じ無向グラフでもrootを変えれば順序が変わります。初期marker、既知の開始標本、実験設計がrootの根拠になります。期待通りの結果を出すrootを選び、同じ期待との一致を独立検証と呼ぶのは循環です。
実習では、観測を最も近い木の辺へ射影し、rootからその点までの木に沿う距離を測ります。同じクラスタ内の全点に同一値を与える方法より細かくなります。木から離れた距離、つまり射影誤差は別途報告します。
Pseudotimeの単位は埋め込みの距離です。座標尺度を変えると値も変わります。長い枝が長い時間を要するとは限らず、別の枝で同じ値でも同期した生物学的時点とは限りません。細胞周期のループも、この木の座標では忠実に表せません。
6. Pythonとroot変更実験
以下は全スクリプトと共通の木の構成です。
from common import make_dataset, prepare_embedding
from sklearn.cluster import KMeans
from scipy.spatial.distance import cdist
from scipy.sparse.csgraph import minimum_spanning_tree

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
km = KMeans(n_clusters=14, n_init=10, random_state=7).fit(Z[data["train"]])
centers = km.cluster_centers_
tree = minimum_spanning_tree(cdist(centers, centers))
print(tree.nnz, len(centers) - 1)
python lesson07.py --output outputsを実行します。最初のrootは、既知の初期学習観測の平均に最も近い代表点です。第2パネルでは、そこから最も遠い木の頂点へ変更します。星が各パネルのrootです。
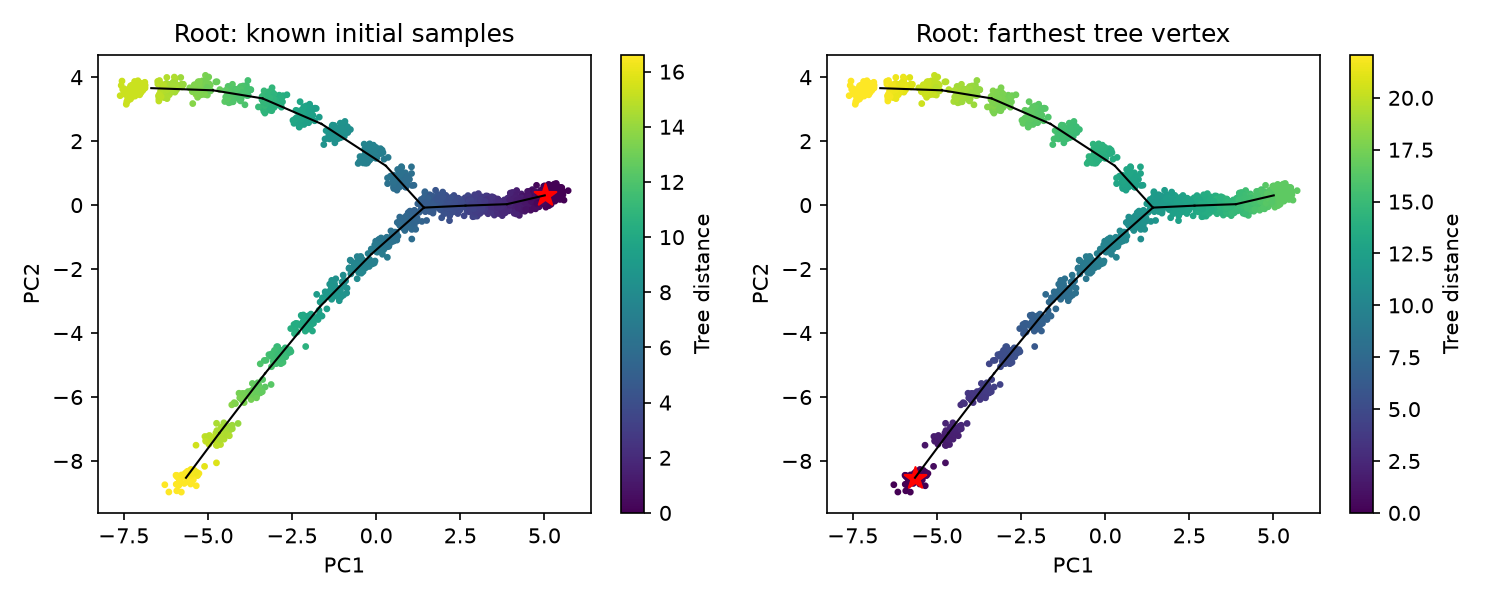
JSONは評価セッションの射影誤差、観測時間とのSpearman相関、別rootでの相関を報告します。表現と木は学習セッションだけで適合し、評価観測は後から射影します。固定した幾何復元の診断であり、未来予測や正しい祖先関係の証拠ではありません。合成データの真の隠れ座標は適合に使いません。
7. 細胞と物語で何を確かめるか
細胞では発達markerと独立標本で幹と分岐を検証します。破壊的なsequencingでは、異なる細胞を異なる段階で測る場合が多く、近いことは直接の祖先関係を示しません。Lineage tracingは別種の証拠です。
会話では似た物語状態から異なる続きへ進むことが分岐かもしれません。しかし、言語やキャラクターで分かれただけなら、物語よりエンコーダーの性質を見ている可能性があります。会話には実際のターン順序があるため、推定経路をセッション内遷移と比較できます。オンライン応用では分析時点までの窓だけを使います。
8. 演習と解答
- MSTにaffinityを入れると、なぜ意図が逆になりますか。 小さい類似度は似ていないことを意味しますが、最小化は小さい値を選びます。長さか根拠ある費用変換を使います。
- 収集時間との高い相関は分岐の正しさを証明しますか。 いいえ。時刻順をよく再現しつつ誤った終点を結ぶこともあります。Topologyを別に検証します。
- 真の経路にループがあれば何が起きますか。 木は少なくとも一つの接続を切ります。閉路を許す方法と比較し、その切れ目を発見された生物学的事件と解釈しません。
次回は観測順序を使い、幾何だけから順番を推測する代わりに遷移確率を推定します。