順序が分かれば、「どの点が近いか」から「現在の状態の次に何が来るか」へ質問を変えられます。Markov modelは遷移表で答えます。HMMは状態ラベル自体が不確かであることを組み込みます。State space modelは隠れ状態を連続ベクトルへ拡張します。
前提知識: 条件付き確率、行列積、clustering、動的計画法。90分: 例10分、Markov推定15分、HMM推論30分、実習20分、連続状態と応用15分。目標はセッション境界を越えずに遷移を数え、各推論がどの時点の観測を使うか説明することです。
共通の環境、lesson08.py、実習一式を使います。
1. 二つの短い列は一つの長い列ではない
二つのセッションの状態がA, A, BとC, Cだとします。観測したのはA→A、A→B、C→Cです。B→Cは観測していません。行を連結し、隣接行すべてを数えると存在しなかった遷移を作ってしまいます。
2次元平面にA、B、Cを置き、観測した矢印を描きます。距離だけでは矢印の方向や確率は決まりません。近い状態がほとんど連続しない場合も、遠い状態へ頻繁に飛ぶ場合もあります。第5講の類似度に基づくランダムウォークとの本質的な違いです。
1次Markov仮定は
$$P(s_{t+1}\mid s_t,s_{t-1},\ldots)=P(s_{t+1}\mid s_t)$$です。現在の状態が分かれば、過去を追加しても次状態の確率が変わらないというモデル仮定です。次元削減だけで保証されません。表現が必要な過去情報を十分保持して初めて、有用な近似になります。未解決の事件や以前の約束を記憶する会話では特に強い仮定です。
2. 遷移行列を推定する
学習セッション内で$i$の次に$j$が出た回数を$N_{ij}$とします。状態数$K$、対称なpseudocount $a>0$に対し、
$$A_{ij}=\frac{N_{ij}+a}{\sum_jN_{ij}+Ka}$$と推定します。少ない標本で見なかったというだけで、遷移確率を0にしないためです。しかし、物理的に可能と証明するものではありません。禁止されると分かっている遷移には、構造的な制約を指定します。
各行の和は1です。行ベクトルの分布は$p_{t+1}=p_tA$で変化します。同じ行列が時間を通して成り立ち、stepの間隔も同じなら、$A^h$は$h$ step後の遷移を示します。会話の1ターンと1時間は異なる単位です。不規則な間隔を同じ間隔と見なさず、追加のモデル化を考えます。
実習では学習観測でk-meansを適合し、その中心に全観測を割り当て、ラベル間の遷移を数えます。このラベルは学習した離散化であり、既知の正解状態ではありません。
3. HMM: 隠れ状態が不確かな観測を生成する
隠れ状態を$s_t\in\{1,\ldots,K\}$、観測されたPCAベクトルを$r_t$とします。HMMは初期分布$\pi$、遷移行列$A$、emission density $b_j(r)=p(r\mid s=j)$を組み合わせます。
$$p(s_{1:T},r_{1:T})=\pi_{s_1}b_{s_1}(r_1) \prod_{t=2}^TA_{s_{t-1},s_t}b_{s_t}(r_t).$$現在の隠れ状態を与えると、その観測は他の観測と条件付き独立と仮定します。連続座標にはGaussian emissionが便利なbaselineです。確率密度は離散的な確率とは違い、1を超える場合があります。
固定モデルに対する列のlikelihood評価、状態の推論、モデルパラメータの学習は別の問題です。RabinerのHMMチュートリアルは古典的なアルゴリズムをこの三つに整理しています。
4. Forward、backward、Viterbi
Forwardは、ある状態で終わる全履歴の確率を足し合わせます。$\alpha_t(j)=p(r_{1:t},s_t=j)$とすると、
$$\alpha_1(j)=\pi_jb_j(r_1),\qquad \alpha_t(j)=b_j(r_t)\sum_i\alpha_{t-1}(i)A_{ij}.$$列のlikelihoodは$\sum_j\alpha_T(j)$です。経路の列挙は指数的ですが、同じ終端状態の結果を再利用する動的計画法により、密な遷移行列で$O(TK^2)$の計算になります。長い列では小さい確率の積がunderflowするため、stepごとに正規化するかlog spaceを使います。
Backwardは残りの観測を要約します。$\beta_t(i)=p(r_{t+1:T}\mid s_t=i)$なら、
$$\beta_T(i)=1,\qquad \beta_t(i)=\sum_jA_{ij}b_j(r_{t+1})\beta_{t+1}(j).$$列全体を見たsmoothed posteriorは$\alpha_t(i)\beta_t(i)$に比例し、時点$t$以降の観測も使います。対して、$\alpha_t$だけを正規化したfiltered distributionは、その時点までの観測だけを使います。オンライン予測にsmoothed stateを入れると未来情報が漏れます。
Viterbiは各時点の勝者を別々に選ぶのではなく、一本の経路全体の確率を最大化します。Log spaceでは
$$\delta_t(j)=\log b_j(r_t)+\max_i\{\delta_{t-1}(i)+\log A_{ij}\}$$です。最大値を与える直前の状態を記録し、最後の勝者から逆にたどります。maxをlogsumexpに替えるとforward更新になります。最大の経路と全経路の和は別の質問なので、Viterbi経路は時点ごとのposterior最大状態と一致するとは限りません。StanfordのHMM章には動的計画法による説明もあります。
5. Python: 推論と学習を分ける
全スクリプトはlog-space forward/backwardとViterbiを直接実装します。遷移計数はnext_indexでセッション境界を守ります。
from common import make_dataset, prepare_embedding
from sklearn.cluster import KMeans
from lesson08 import estimate_transitions

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
km = KMeans(n_clusters=6, n_init=10, random_state=7).fit(Z[data["train"]])
labels = km.predict(Z)
A = estimate_transitions(labels, data["next_index"], data["train"], 6)
print(A, A.sum(axis=1))
python lesson08.py --output outputsを実行します。全体では学習クラスタの平均と分散で対角Gaussian emissionを初期化し、学習セッションの開始ラベルから初期分布を作ります。Baum–Welchは実行しません。 Baum–WelchはEMで、期待状態数・期待遷移数の推論とパラメータ更新を繰り返します。有用な発展課題ですが、現在のbaselineで実施したとは言えません。
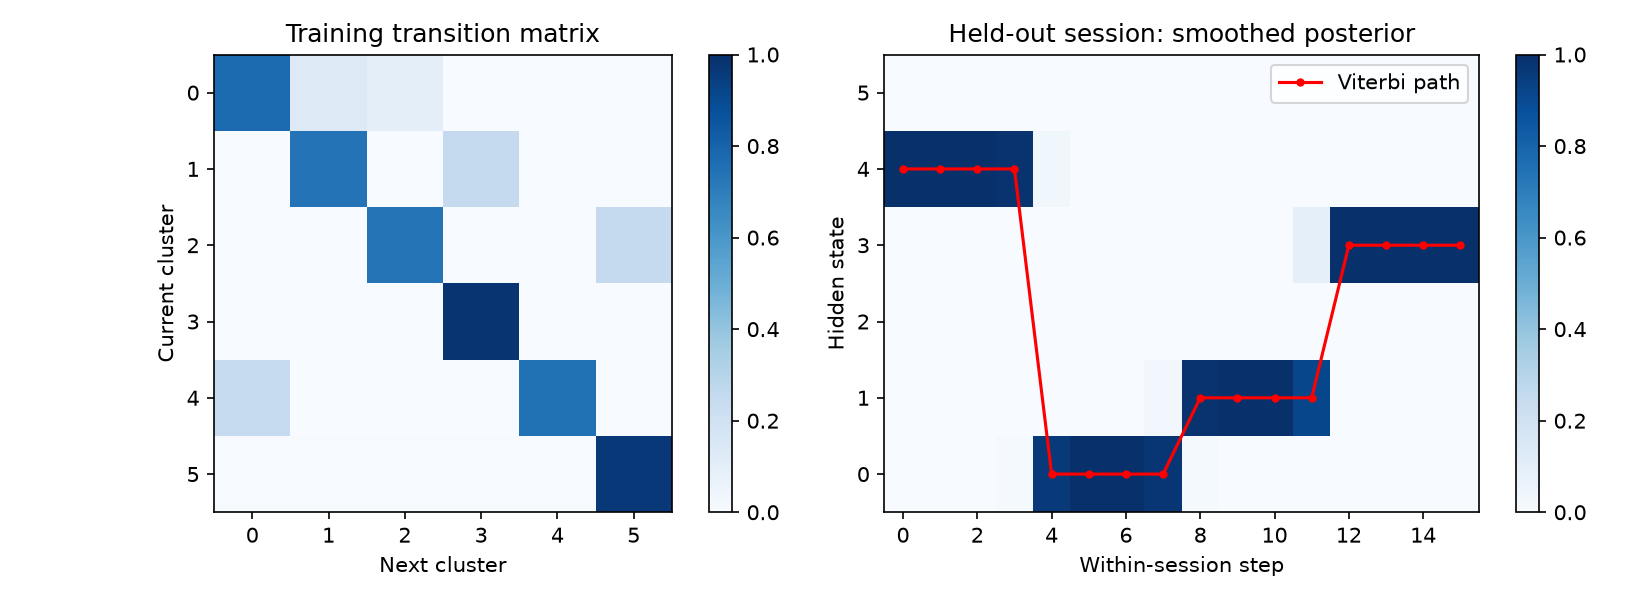
遷移の指標は、評価セッションでの次クラスタnegative log-likelihoodで、学習データの周辺頻度baselineと比べます。HMMの指標はstepあたりの観測log densityです。異なる予測を評価するため、同じスコアとして数値比較できません。図のposteriorは完成した評価セッション全体をsmoothingした事後分析です。セッション単位で分割するため、評価対象の未来ターンをパラメータ学習には使いません。
6. 連続的なState Space Model
隠れ状態がカテゴリ間を跳ぶ代わりに、連続ベクトルとして変化するモデルもあります。線形Gaussianモデルは
$$z_{t+1}=Fz_t+\epsilon_t,\quad \epsilon_t\sim\mathcal N(0,Q),$$$$r_t=Hz_t+\eta_t,\quad \eta_t\sim\mathcal N(0,R)$$です。Gaussianの初期状態と独立Gaussian雑音の下で、Kalman filterは平均と共分散を再帰的に予測し、新しい観測で修正します。予測平均を$m_t^-$とすると、
$$m_t=m_t^-+K_t(r_t-Hm_t^-)$$という形で更新します。括弧内は実際の観測と予想との差です。Kalman gain $K_t$は不確かさから決まり、観測雑音が大きければ観測を弱く信じ、予測が不確かなら大きく修正します。Kalmanの原論文がこの再帰的推定を展開します。一般的な非線形モデルには別の推論や近似が必要で、SSMという名前の全モデルがKalman filterを使うわけではありません。
7. 細胞、会話、演習
生物学では、同じ細胞を追跡した反復観測が遷移推定を支えます。別の時点で集めた対応不明の細胞だけから、個別遷移は自動的には得られません。キャラクター会話にはセッション内の対応がありますが、ターン長、話者、プロンプト、介入で遷移確率が変わることがあります。予測上の関連は因果効果とは限りません。
A,A,BとC,Cをsmoothingなしで数えてください。 AからAとBへ各1/2、CからCへ1です。Bには次状態の観測がなく、その行をデータだけでは推定できません。- 千stepの確率をそのまま掛けると何が問題ですか。 Underflowし得ます。正規化したforward message、またはlog probabilityと
logsumexpを使います。 - オンラインで図のsmoothed posteriorを使えますか。 セッション途中の予測には使えません。Backwardが未来を読むからです。Filteringを使い、予測時点に存在する情報だけで評価します。
これで実際の遷移の根拠を得ました。次回は移動の大きさと方向をvector fieldで学習します。