軌道はシステムが通ってきた位置を示します。ベクトル場は現在の状態から向かう方向を表します。状態の地図を予測モデルに変える段階です。ただし矢印の意味は、座標系と推定の根拠によって制限されます。
前提と時間配分。 PCA、回帰、Markovモデル、微分の意味を復習してください。90分を差分15分、ベクトル場とRNA反応式20分、Python実習35分、誤差の検討20分に分けます。隣接観測を正しく組にすること、1ステップ予測と自由なロールアウトを比較すること、RNA velocityと会話の変化量を区別することが目標です。共通の準備、完全なコード、実習一式を使います。
一つの動きを測る
横軸を物語の進行度、縦軸を緊張度とします。時刻2の位置が$(1,0)$で、時刻2.5には$(1.2,0.3)$になりました。変位は$(0.2,0.3)$ですが、平均速度は単位時間あたり$(0.4,0.6)$です。観測間隔の異なる動きを比較するには、経過時間で割る必要があります。
$$ \widehat v_i=\frac{z_{i+1}-z_i}{\Delta t_i},\qquad \Delta t_i=t_{i+1}-t_i>0. $$これは区間の平均変化率です。十分に滑らかな軌道を短い間隔で観測するとき、微分に近づきます。会話ではターンを時間単位にしても構いません。ただし、1ターンあたりと1分あたりの速度は異なる問いに答えます。一晩中断した会話を通常の1ステップとして扱うかは、分析目的に合わせて決めます。
分岐にも注意が必要です。同じ位置から上と下へ進む場合、二乗誤差の回帰は平均を取り、データのない中間方向を指すことがあります。表現が捨てた情報は、標本数を増やすだけでは戻りません。履歴や文脈を状態に含めるか、次状態の分布を予測します。
矢印から関数へ
観測した速度を近似する関数を学習します。
$$ \min_\theta\sum_{i\in\mathcal T} \left\|f_\theta(z_i,t_i)-\widehat v_i\right\|_2^2. $$今回の入力には時刻も含めます。$z$だけを使うモデルは、同じ状態なら到達時刻にかかわらず同じ平均速度を持つと仮定します。これは散布図から自動的に決まる性質ではありません。
基準モデルは入力が近い学習データ40点の速度を平均します。構造がわかりやすく、ノイズを平滑化できます。ニューラルネットワークに置き換える前に、未知のセッションでこの基準を上回れるか確認しましょう。
差分は観測ノイズを増幅します。独立な2回の測定のノイズ分散がそれぞれ$\sigma^2$なら、差を$\Delta t$で割った値の分散は$2\sigma^2/\Delta t^2$です。観測間隔を短くするだけでは推定は安定しません。必要に応じて反復測定、平滑化、不確実性のモデル化を使います。ただし別々のセッションをつなげて平滑化してはいけません。
Pythonで正しい観測ペアを作る
共通データには120個の合成セッションと固定の観測期間があります。スケーリングとPCAは学習セッションで適合します。次は完全なスクリプトに含まれるペア作成と回帰の部分です。
import numpy as np
from sklearn.neighbors import KNeighborsRegressor
from common import make_dataset, prepare_embedding

data = make_dataset()
_, Z, _, _ = prepare_embedding(data)
current = np.flatnonzero(data["next_index"] >= 0)
following = data["next_index"][current]
dt = data["time"][following] - data["time"][current]
velocity = (Z[following] - Z[current]) / dt[:, None]
features = np.column_stack([Z[current], data["time"][current]])
fit = data["train"][current]
model = KNeighborsRegressor(n_neighbors=40, weights="uniform")
model.fit(features[fit], velocity[fit])
predicted = Z[current[~fit]] + dt[~fit, None] * model.predict(features[~fit])
展開した実習フォルダでpython lesson09.py --output outputsを実行します。完全版は、時間差が正であることと、ペアのセッションIDが同じことを検証します。z_trueは学習に使いません。行が隣接しているだけで差を取ると、ある人の終了地点から別の人の開始地点へ架空の移動を作ってしまいます。
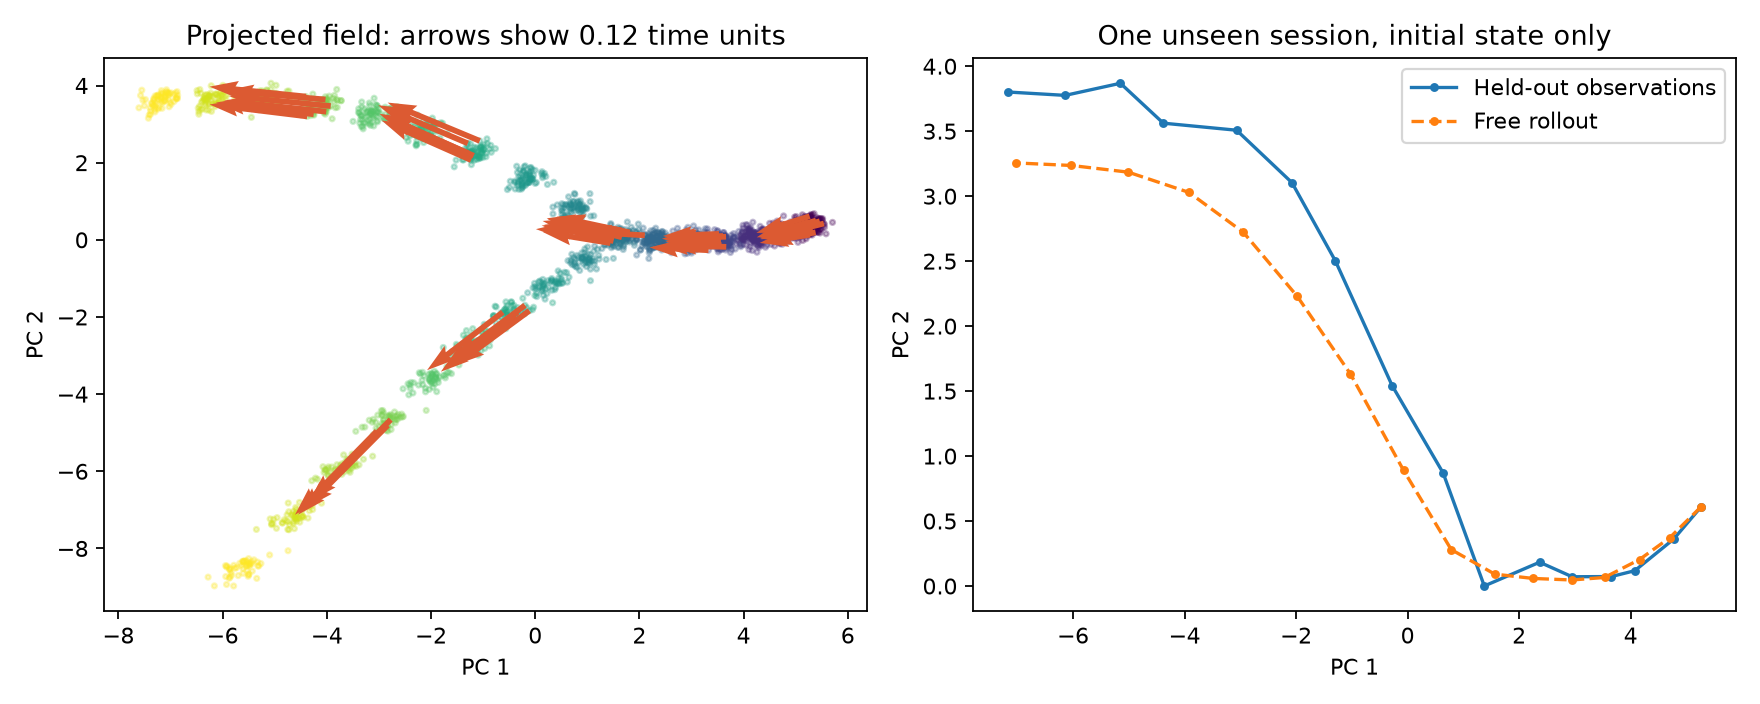
左の矢印は0.12時間単位の移動量を表します。右は未知セッションの実際の初期状態だけを与え、次の更新を繰り返した結果です。
$$ \widehat z_{k+1}=\widehat z_k+\Delta t_k f_\theta(\widehat z_k,t_k). $$1ステップ評価では毎回実際の状態を入力します。teacher forcingに相当する評価なので、自分の誤差が蓄積した入力には対応しません。自由なロールアウトは直前の予測を再入力する、より難しい課題です。
同梱のシードで、1ステップMSEは約0.035、現在位置を維持する基準は0.516でした。ロールアウトMSEは約7.51まで増えます。初期位置にとどまり続ける基準の26.74よりは良いものの、局所的な予測成功が長い軌道の再現を保証しないとわかります。これは座標に依存する合成データの誤差であり、生物学的性能ではありません。
RNA velocityが補う情報
通常の単一細胞RNAシーケンシングでは、測定した細胞を翌日もう一度測ることができません。同一細胞の翌日の発現量から今日の発現量を引く方法は使えません。RNA velocityは未スプライスRNAとスプライス済みRNAの情報から、発現の局所変化率を推定します。元論文と補足資料には推定と可視化の限界も説明されています。La Manno et al., 2018
1遺伝子の単純な反応式は
$$ \frac{du}{dt}=\alpha-\beta u,\qquad \frac{ds}{dt}=\beta u-\gamma s. $$です。$u$は未スプライス量、$s$はスプライス済み量、$\alpha,\beta,\gamma$は転写、スプライシング、分解の係数です。$u=4,s=3,\beta=\gamma=1$なら$s$の変化率は$1$です。次の細胞を直接観測した結果ではなく、反応モデルによる推論です。
定常状態や反応速度の仮定が崩れると推定は誤ります。scVeloは過渡状態を扱う動力学モデルへ拡張しますが、不確実性やモデルの誤指定が消えるわけではありません。Bergen et al., 2020
会話には実際の観測順序がありますが、埋め込みはエンコーダ、文脈窓、話者、プロンプトの影響を受けます。移動平均の窓そのものが滑らかな経路を生む場合もあります。この実習が推定するのは物語の特徴の変化であり、RNA velocityではありません。
座標系が主張を制限する
固定線形射影$z=W^\top x$なら速度は$v_z=W^\top v_x$です。微分可能な非線形エンコーダ$z=g(x)$なら局所的には$v_z=J_g(x)v_x$になります。UMAPの図に矢印を置くだけでは、この計算を行ったことにはなりません。
2次元で失われる方向もあり、埋め込みの歪みで速さが違って見えることもあります。図をモデル診断として使い、科学的な問いに適した空間でも検証します。状態を変更すれば未来が変わるかという因果の問題は、第12講で扱います。
演習
- 単位を確認する。 4ターンで$(2,-1)$移動したときの速度は? 答え: 1ターンあたり$(0.5,-0.25)$。各ターンの長さが異なるなら、時刻なしで分単位へ換算できません。
- 評価を変える。 自由ロールアウトの入力を毎回実際の状態に置き換えると、なぜ誤差が下がりやすいでしょうか。ヒント: 自分の予測誤差に耐える必要がなくなり、別の課題になっています。
- 不足する記憶を調べる。 同じ2D地点を逆方向に通過する2経路を作ります。予想: 両者が動いていても平均矢印はほぼゼロになります。直前の速度を入力に追加し、新しいセッションで比較してください。
次は、各時刻で集団だけを観測できるとき、どの移動を推論できるか考えます。