ニューラルネットワークで速度を予測し、数値ソルバーで状態を少しずつ動かすと、連続経路モデルになります。これがNeural ODEの中心です。同じ仕組みで確率分布全体も動かせます。ただし、その移動の意味は学習に与えた根拠で決まります。実際の観測時刻と生成用の人工的な時計は交換できません。
前提と時間配分。 微分、ニューラルネットワークの回帰、第9講のベクトル場、第10講のカップリングを復習します。100分をODE20分、確率性と密度15分、Flow MatchingとPython35分、診断30分に分けます。実行できる2D生成モデルと、それが特定できないものを説明することが目標です。準備、完全なPyTorch実習、実習一式を使います。
小さな移動は残差更新
$(0,0)$から一定速度$(1,2)$で始めます。$h=0.1$として$z\leftarrow z+h(1,2)$を10回更新すると$(1,2)$へ到達します。学習した速度なら
$$ z_{k+1}=z_k+h f_\theta(z_k,t_k) $$となります。これが陽的Euler法です。この離散更新が近似する連続モデルは
$$ \frac{dz}{dt}=f_\theta(z,t),\qquad z(t_1)=z(t_0)+\int_{t_0}^{t_1}f_\theta(z(t),t)\,dt $$です。ネットワークは微分を指定し、ソルバーは経路を評価します。刻み幅を小さくすれば数値誤差は減らせますが、誤ったベクトル場は修正できません。適応ソルバーは許容誤差に応じて計算量を変えます。硬い方程式では依然として計算が高価になり得ます。Neural ODEの論文は、パラメータ化した動力学と数値積分を結び付けます。
解の一意性を与える正則条件のもとで、完全に同一の初期状態は決定論的ODEに沿って一つの経路を進みます。初期分布から二峰性の終点分布を作ることは、同一状態の個体を確率的に分岐させることではありません。同じ観測から複数の未来を表すには、潜在初期状態の不確実性、条件情報、確率的な動力学などが必要です。
ノイズはモデルを変える
Itô SDEは
$$ dz=f_\theta(z,t)\,dt+\Sigma(z,t)\,dW_t $$と書けます。ドリフト$f_\theta$は局所的な平均移動、拡散行列$\Sigma$はランダムな変動を制御します。$W_t$はBrownian motionです。時間幅$h$の増分の分散は$h$に比例するので、Euler–Maruyama法では
$$ z_{k+1}=z_k+h f_\theta(z_k,t_k)+\sqrt h\,\Sigma(z_k,t_k)\xi_k, \qquad \xi_k\sim\mathcal N(0,I) $$を使います。$\sqrt h$を$h$に置き換えると、刻みを小さくしたときのノイズの性質が変わります。状態依存のノイズではItôとStratonovichの解釈でドリフトが異なる場合があります。ここではItô表記を使い、実習では決定論的な場合だけを実装します。
Flowは密度も運ぶ
可逆写像$y=g(x)$について、変数変換公式は
$$ \log p_Y(y)=\log p_X(x)-\log|\det J_g(x)| $$です。これがnormalizing flowの基本的な見方です。十分に正則な連続flowでは局所的に
$$ \frac{d}{dt}\log p_t(z(t))=-\nabla\!\cdot f_\theta(z(t),t) $$となります。体積を広げる場では、経路に沿って密度が下がります。このため軌道の学習と分布モデルが同じ仕組みを使えます。今回の実習は尤度や発散を評価せず、速度を学習します。Flowを定義するネットワークだからといって、計算していない尤度を報告してはいけません。
Flow Matchingは回帰の正解を作る
初期点$x_0$と後期点$x_1$を選び、人工時刻$t\in[0,1]$を無作為に取ります。
$$ x_t=(1-t)x_0+tx_1,\qquad u_t=x_1-x_0. $$直線区間が入力と正確な条件付き速度の両方を与えます。そこで
$$ \mathcal L(\theta)=\mathbb E_{x_0,x_1,t} \left\|f_\theta(x_t,t)-(x_1-x_0)\right\|_2^2 $$を最小化します。別の端点ペアが同じ$(x_t,t)$付近を異なる速度で通ることがあります。二乗誤差回帰は条件付き平均を学びます。適切な仮定と理想的な学習のもとでは、この平均場が選んだ確率経路の分布を輸送します。実際には有限データ、有限容量、最適化の誤差が残ります。各学習ステップでODEを解かずに速度回帰を行える点がconditional Flow Matchingの利点です。Lipman et al., 2022
端点の結合はモデルの選択です。実習では二つの端点を独立に抽出します。OTペアを使わず、隠されたセッションの個体対応も復元しません。また、条件付き訓練区間が直線だからといって、生成経路がすべて直線になるわけではありません。
Pythonで学習して積分する
前の講義と同じ合成観測を使います。PCAと追加の座標標準化は学習セッションだけで適合します。初期フレーム($t_{\mathrm{obs}}\leq0.15$)が出発分布、後期フレーム($t_{\mathrm{obs}}\geq0.85$)が到着分布です。64ユニットの隠れ層を二つ持つネットワークに、状態座標二つと補間時刻を入力します。
次のコードはダウンロードした実装を使い、前処理、700回のミニバッチ更新、Euler積分、診断をすべて実行します。
from pathlib import Path
from lesson11 import run

metrics = run(Path("outputs"))
print(metrics["endpoint_sliced_w1"])
print(metrics["euler_refinement_rmse"])
python lesson11.py --output outputsでも実行できます。完全なコードの学習ループは128ペアを抽出し、凸補間を作り、速度MSEをAdamで最適化します。CPUで読んで変更できる小さなモデルです。
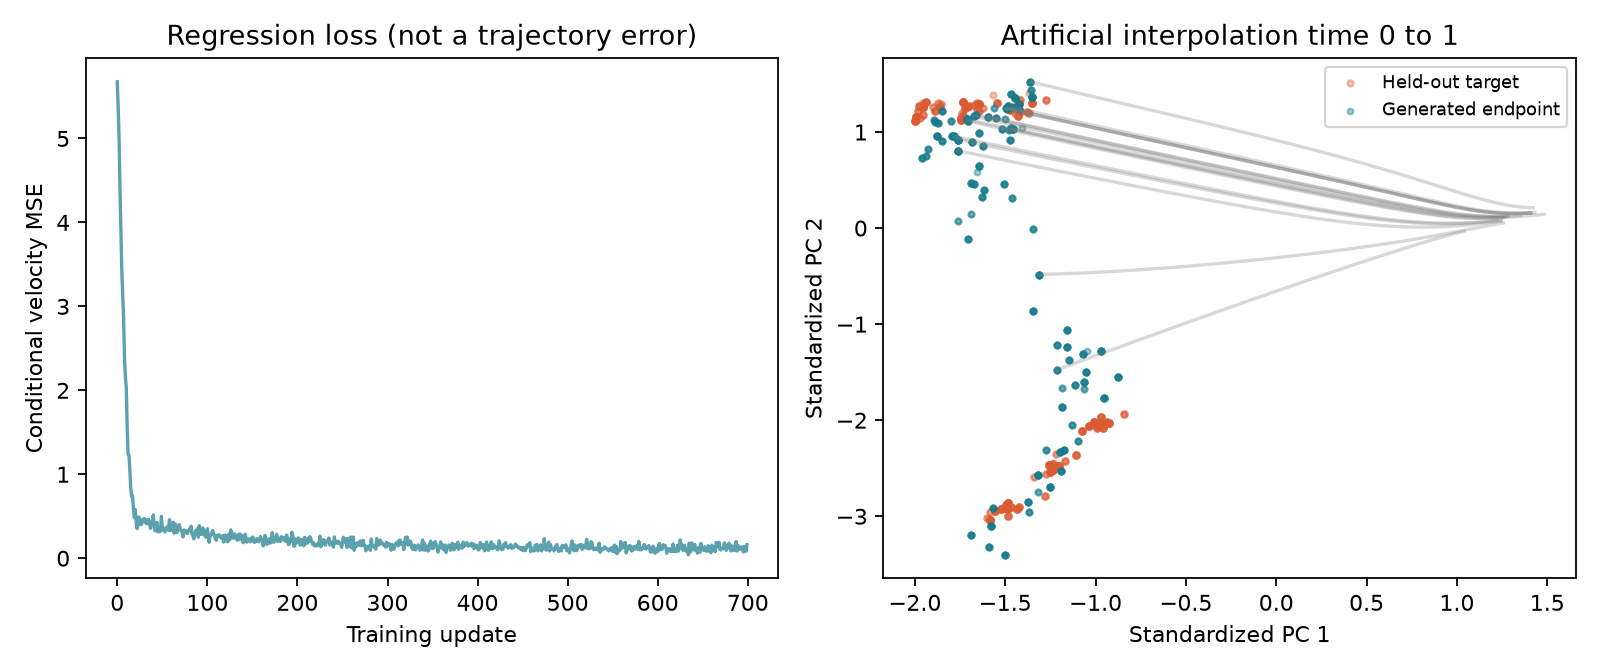
テストは未知セッションの初期観測から始め、生成された終点を未知セッションの後期観測と比較します。Sliced $W_1$診断は64方向に両分布を射影し、それぞれを整列して対応する分位点の絶対差を平均します。分布の比較であり、個体別の軌道誤差ではありません。
指定シードでは、この値は輸送前の約2.17から輸送後の約0.45へ下がります。Eulerステップを80から160へ増やすと、同じ初期標本の終点の差のRMSEは約0.024です。前者は分布一致、後者は数値感度を検査します。どちらも正しい生物学的動力学の証明ではありません。低い学習損失だけなら、さらに弱い証拠です。
生物学的な時計は別の主張
実際の反復観測に適合したモデルなら、実時間の予測を試みられます。それでも適切な状態変数、時間方向の検証、不確実性の分析が必要です。今回の生成モデルは端点分布と人工補間しか見ていません。同じ端点を結ぶ中間経路は多数あります。
生物では滑らかな生成経路が集団移動の仮説になりますが、検証には中間時点の測定や摂動が必要です。会話の「導入」と「解決」の埋め込みを結ぶ経路は、実際の会話が到達できない領域を通るかもしれません。デコード、文脈の整合性、実際の未知セッションとの比較は追加の検査であり、端点一致から自動的に得られません。
Schrödinger bridgeは基準となる確率過程を置き、相対エントロピーでその過程に近く、両端の周辺分布を満たす経路分布を探します。確率制御と輸送をつなぐ拡張ですが、今回の独立ペアによるFlow Matchingの別名ではありません。De Bortoli et al., 2021
演習
- 誤差を分ける。 再学習せずEulerの刻み幅を半分にすると、どの誤差が改善し得ますか。答え: 数値積分誤差です。表現、推定、端点だけからの識別の問題は残ります。
- ノイズの尺度。 $\sigma=2,h=0.01$の1ステップの標準偏差は? 答え: $\sigma\sqrt h=0.2$であり、$0.02$ではありません。
- 学習していないものを調べる。 生成経路を未知セッションの中間観測と比較してください。ヒント: 終点分布が似ていても時間経路は誤り得ます。補間時刻と観測時刻に別の名前を付けましょう。
最終講では経路の結果を予測し、入力の変更に因果的な意味を与える条件を考えます。