ある状態で離脱が多いことと、その状態を変えれば離脱が減ることは、別の主張です。前者は予測、後者は因果推論の問題です。最終講では「いつイベントが起きるか」「どの結末へ進むか」「介入で何が変わるか」を、それぞれに必要なデータと仮定で考えます。
前提と時間配分。 条件付き確率、回帰、評価分割、第8講の時系列を復習します。100分を打ち切りと生存分析25分、帰結予測20分、因果識別25分、Pythonと最終課題30分に分けます。目標は、三つの問いを混ぜず、弱い予測結果も報告し、因果効果を主張できる条件を説明することです。共通の準備、lesson12.py、実習一式を使います。生存分析にはlifelinesを使用します。
三つの問いには三つの目的変数
2次元の物語状態を、横軸は進行、縦軸は緊張として描きます。右上に離脱が集中していても、緊張が原因とは限りません。もともと関与の低いユーザーがそこへ進み、同時に離脱しやすいのかもしれません。色で塗ったリスク地図には、介入の矢印は含まれていません。
共通データにも三つの異なる目的があります。fateは最終分岐の0/1ラベルです。durationとeventは、後続の追跡イベントを表します。outcomeは、無作為に割り付けたtreatmentの後に測る連続結果です。これらを同じ「成功」と呼んで指標を混ぜないでください。
特に時計を区別します。各セッションの16フレームは、観測時刻0から1まで完全に存在します。生存分析の時計はこの観測窓が終了してから始まります。追跡中の離脱後に未来の会話を観測している、という設定ではありません。初期部分からのfate予測と、観測窓後のイベント追跡は別の課題です。
右打ち切りは「イベントなし」と違う
イベントまでの真の時間を$T$、観測を終える時刻を$C$とします。実際に記録するのは
$$U=\min(T,C),\qquad \delta=\mathbf1[T\leq C]$$です。$\delta=0$なら「$U$まで起きなかった」と分かるだけで、「永久に起きない」とは分かりません。これが右打ち切りです。打ち切られた人を除くと長く続く人を落としやすくなり、$U$を全員のイベント時刻として平均するのも誤りです。lifelinesの生存分析入門には、この違いとデータの持ち方が説明されています。
生存関数は、イベントがまだ起きていない確率です。
$$S(t)=P(T>t).$$連続時間のhazardは確率そのものではなく、条件付きの発生率です。
$$h(t)=\lim_{\Delta t\downarrow0} \frac{P(t\leq TKaplan–Meierを手で計算する
4人を追跡し、イベントが時刻2と4に一人ずつ、打ち切りが時刻3と5に一人ずつあったとします。イベント時刻$t_j$の直前に追跡下で未発生の人数を$n_j$、イベント数を$d_j$とすると、
$$\widehat S(t)=\prod_{t_j\leq t}\left(1-\frac{d_j}{n_j}\right).$$時刻2では$n_1=4,d_1=1$なので$\widehat S(2)=3/4$です。時刻3の打ち切りでは曲線は下がりません。その人を以降のrisk setから外します。時刻4では残る2人のうち1人に発生するため、$\widehat S(4)=(3/4)(1/2)=3/8$です。追跡が終わったこととイベントの発生を、別々に計算できました。
これはKaplanとMeierの推定法です。全員をまとめた曲線の解釈には、その集団で打ち切りがイベント時間について非情報的であることが必要です。「共変量を与えれば独立」という条件だけで、無調整の曲線が正当化されるわけではありません。その場合は適切な層別化や調整が必要です。本実習の打ち切りは生成時に独立なので、この点は満たします。残る人数が少ない後半ほど不確実性が大きくなることも確認します。
Coxモデルで条件付きhazardを比べる
Cox比例ハザードモデルは、共変量$w$を使って
$$h(t\mid w)=h_0(t)\exp(\beta^Tw)$$と表します。$h_0(t)$は基準hazardです。同じ他の条件で特徴が1増えたときのhazard比は$e^{\beta_j}$になります。これはイベント確率の比ではありません。共変量が固定されているなら、この比が時間で変わらないという比例ハザード仮定も入ります。
イベント時刻が重ならない場合、係数を学ぶ部分尤度は
$$L(\beta)=\prod_{i:\delta_i=1} \frac{\exp(\beta^Tw_i)}{\sum_{j\in R(U_i)}\exp(\beta^Tw_j)}$$です。その時点のrisk set $R(U_i)$の中で、誰にイベントが起きたかを比較するため、基準hazardが比から消えます。時刻が同じイベントには別途tiesの扱いが必要です。Coxの原論文とlifelinesの実装を参照してください。
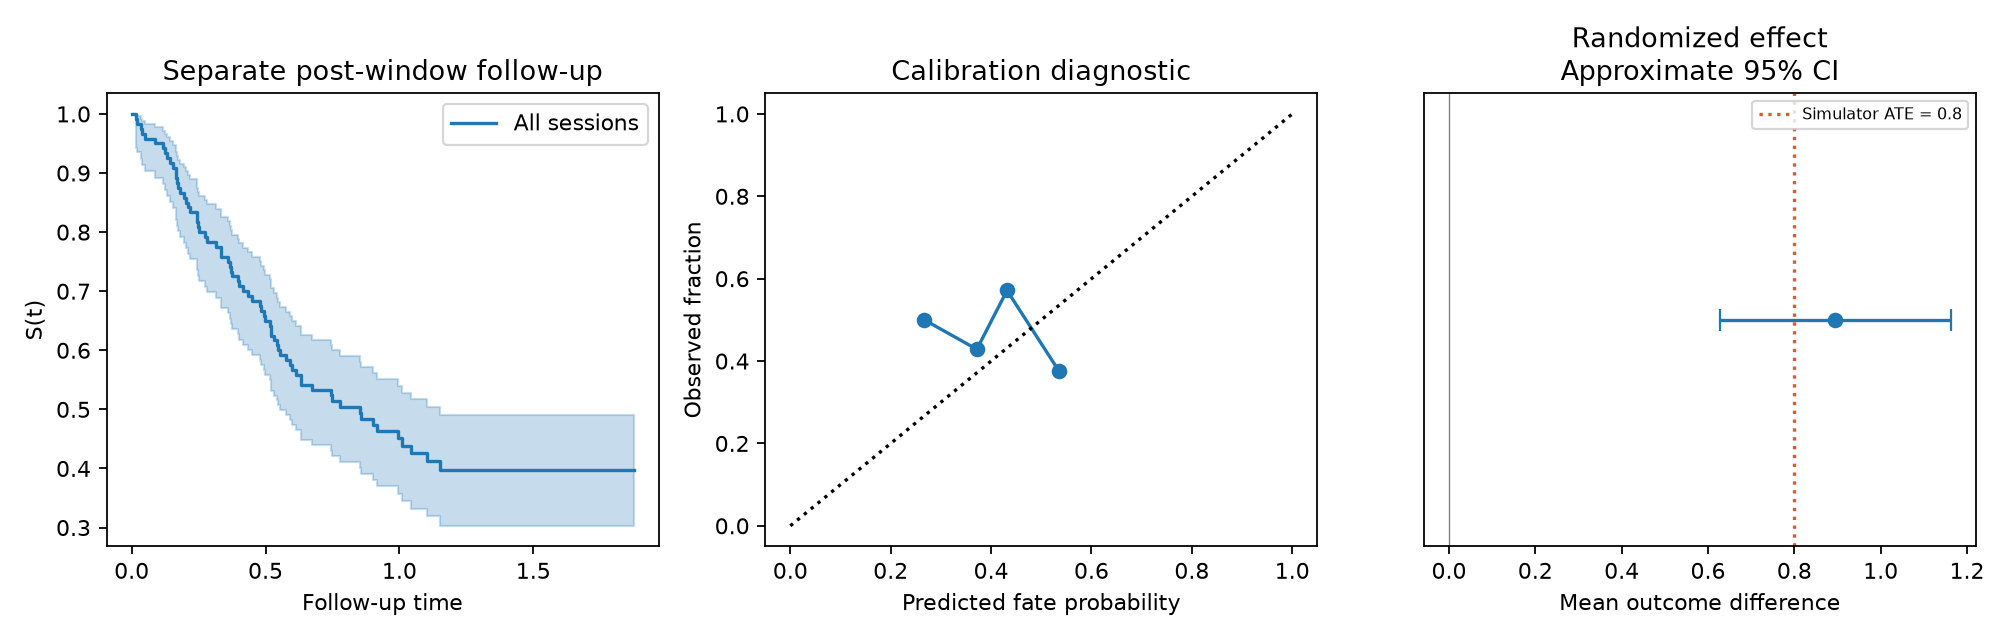
実習は学習90セッションのbaselineとtreatmentを使い、少し正則化して適合します。評価30セッションのconcordanceは約0.515です。比較可能なペアの順序がどれだけ合うかという診断であり、強い予測性能を示しません。打ち切りで比較できないペアもあります。Cox係数を出しただけで、較正、比例ハザード仮定、因果効果が検証済みになるわけではありません。
Fate予測には未来を入れない
現在までの状態から結末を予測するなら、推定対象は$P(F=k\mid\text{時点 }t\text{ までの観測})$です。全セッションの要約は結末を含み得るため、初期状態の特徴として使えません。
実習は観測時刻0.4以下のprefixだけを使います。標準化とPCAも学習セッションのprefixだけで適合し、各セッションの初期PCA座標を平均してロジスティック回帰へ渡します。評価セッションも同じprefixだけを変換します。z_trueや後期フレームは使いません。学習セッションであっても、早期予測用の表現を未来フレームで選ばないことが重要です。
指定seedでの評価AUCは約0.415、Brier scoreは約0.28793です。学習データのfate頻度を全員に返す定数baselineのBrierは約0.25086で、今回のモデルの方が悪くなりました。
$$\operatorname{Brier}=\frac1n\sum_i(\widehat p_i-y_i)^2.$$小さい方が良い確率誤差です。AUCは順位、Brierは確率の誤差を見るため、同じ性質を測りません。30セッションの結果から「原理的に予測不能」とは言えませんが、有用な早期予測に成功したとも言えません。ラベルを反転して評価を良く見せたり、評価結果でモデルを選び直したりせず、失敗として残します。図の較正曲線も小標本なので粗い診断です。
相関から介入へ
交絡因子とは、処置の選択と結果の両方に関わり、観測上の比較をゆがめる要因です。例えば、既に離脱しそうな会話にだけ救済プロンプトを出すと、プロンプト群の離脱率が高くても、プロンプトが悪化させたとは限りません。
処置$A\in\{0,1\}$を受けた場合の潜在結果を$Y(1),Y(0)$とし、平均処置効果を
$$\operatorname{ATE}=\mathbb E[Y(1)-Y(0)]$$と定義します。一人について両方を同時には観測できません。A/Bテストは無作為割り付けで比較群の作り方を制御します。干渉のない明確な処置、結果の適切な観測などの条件のもとで、群間平均差を効果の推定に使えます。HernánとRobinsの『Causal Inference: What If』は、予測と識別の違いを段階的に説明しています。
本実習の連続結果は
$$Y=0.7B+0.8A+\epsilon$$で作ります。$B$は処置前のbaseline、$A$は無作為処置、雑音は平均0です。このシミュレータの真のATEは0.8です。これはfateラベルや生存期間とは別の結果です。
全120セッションで処置群平均から対照群平均を引くと約0.895、独立標本の標準誤差から作る近似95%信頼区間は**約[0.627, 1.163]**です。標本の偶然の偏りがあるので真値とぴったり一致する必要はありません。予測モデル用の学習・評価分割と、無作為化された処置・対照の分割も別物です。この効果推定では全120セッションを使います。
無作為化できない場合の条件
Propensity scoreは、処置前共変量$B$が与えられたときに処置を受ける確率$e(B)=P(A=1\mid B)$です。重み付けやmatchingに使えますが、モデルを当てはめれば自動的に交絡が消えるわけではありません。必要なのは、測った共変量で条件付ければ未測定交絡が残らないexchangeability、比較したい条件で両処置に可能性があるpositivity、実際の処置と潜在結果が対応するconsistencyです。処置後に変化した状態を、処置前交絡因子の代わりに入れるのも危険です。
Difference-in-Differences、DiDは処置群と比較群の変化量を比べます。
$$\widehat\tau_{\rm DiD}= (\bar Y_{\rm treated,post}-\bar Y_{\rm treated,pre}) -(\bar Y_{\rm control,post}-\bar Y_{\rm control,pre}).$$例えば処置群が5から7、比較群が3から4なら推定差は$2-1=1$です。因果解釈には「処置がなければ両群の平均変化は同じ」というparallel trendsが必要です。事前の先取り効果がないこと、観測対象の構成や測定が比較可能であること、比較群への処置の波及がないことも考えます。事前トレンドが似ていることは有用な診断ですが、反実仮想の仮定の証明ではありません。導入時期が複数ある設計には追加の注意が必要です。CallawayとSant’Annaの論文
今回のコードは無作為平均差を実装します。PropensityとDiDは識別条件を学ぶ拡張であり、実行した分析とは区別します。
Pythonと図の読み方
以下はダウンロード実装の全分析を実行するコードです。
from pathlib import Path
from lesson12 import run

metrics = run(Path("outputs"))
print(metrics["fate_auc"], metrics["fate_brier"])
print(metrics["baseline_brier"], metrics["cox_test_concordance"])
print(metrics["randomized_effect"])
print(metrics["effect_ci_low"], metrics["effect_ci_high"])
python lesson12.py --output outputsでも実行できます。左図は全セッションの記述的Kaplan–Meier曲線で、未知データへの予測精度ではありません。中央は評価prefixからのfate確率、右は別の無作為処置結果の平均差です。
生物学なら、発現状態からの分化先予測と、治療で分化先が変わるという主張を分けます。キャラクター会話なら、離脱までの定義と観測終了を先に決め、同じユーザーが複数群にまたがる場合の依存や干渉にも注意します。会話を良くする介入の評価には、単なる滞在時間以外の品質・満足度の指標も必要です。
演習と最終課題
- 時刻3の打ち切りでKM曲線を下げない理由は? イベントを観測したわけではないからです。それ以降のrisk setから除きます。上の例の時刻4の生存率は3/8です。
- 初期fateモデルに全16フレームのPCA平均を渡すと何が変わる? 予測時点に存在しない後期情報が入り、早期予測の評価ではなくなります。変換の学習もprefixに制限します。
- 高リスク者だけに出したプロンプトの群間平均差はATEか? そのままでは違います。処置選択に交絡があります。無作為化、または妥当な識別条件と調整が必要です。
最終課題では、許可された匿名化会話か合成会話で、観測単位、予測時点、最終結果、打ち切りを定義します。表現、近傍、経路、遷移を作った後、単純なbaselineに勝てるかを未使用ユーザーや期間で評価してください。因果的な問いには別の実験計画を添えます。提出には主要図3枚、再現コード、失敗例2件、識別できない点の説明を含めます。
12講を通して学んだのは、状態から経路、動力学、帰結までをつなぎながら、各段階で「データが与えたもの」と「モデルが仮定したもの」を区別する方法です。