산점도는 어떤 관측값들이 비슷한지 보여준다. 어느 점이 먼저였는지는 산점도만으로 알 수 없다. Trajectory ML은 이 차이를 이해하는 데서 출발한다.
캐릭터 대화에 “좋아, 널 믿을게”라는 문장이 등장했다고 하자. 진심 어린 사과 뒤에 나온 말일 수도 있고, 협박에 마지못해 응한 말일 수도 있다. 보이는 문장은 같아도 관계의 상태와 다음 행동은 다를 수 있다. 세포에서도 비슷한 측정 문제가 생긴다. 유전자 발현량은 관측하지만, 그 세포가 어떤 발달 상태에 있는지는 관측으로부터 추론한다.
이 시리즈는 알고리즘 이름 20개를 외우는 수업이 아니다. **어떤 정보가 있어야 관측값으로부터 상태, 경로, 움직임, 최종 결과를 복원할 수 있는가?**라는 질문을 열두 번 다른 도구로 풀어 보는 수업이다.
수업 준비와 90분 구성
Python 배열, 벡터, 평균, 기초 확률을 알고 있으면 시작할 수 있다. 생물학 배경지식은 필요하지 않다. 사례 토론 15분, 관측 모델 20분, 합성 실험 설계 20분, Python 실습 20분, 주장과 한계 점검 15분으로 진행한다. 수업이 끝나면 좌표, 순서, 속도, 결과 예측을 서로 구분할 수 있어야 한다.
먼저 실습 환경과 공통 자료를 확인한다. 전체 실습 묶음에는 공통 데이터 생성기와 강의별 코드가 들어 있다. lesson01.py는 묶음의 common.py와 함께 실행한다. 모든 데이터는 로컬에서 합성하며 계정이나 외부 데이터 다운로드는 필요하지 않다.
한 관측값에 여러 설명이 가능하다
한 번의 관측을 $x\in\mathbb R^D$라고 쓰자. 각 좌표는 정규화한 유전자 발현량, 대화 임베딩의 한 좌표, 또는 직접 측정한 대화 특징일 수 있다. 그 뒤에 더 작은 상태 $z\in\mathbb R^d$, $d\ll D$가 있다고 가정한다.
$$ x=g(z)+\epsilon. $$$g$는 상태를 관측값으로 바꾸는 함수이고, $\epsilon$은 측정 잡음과 설명하지 못한 변동이다. 이번 프로젝트는 두 개의 상태 좌표를 섞어 24개 특징을 만든다. 실제 유전자 발현 데이터에서는 한 세포를 설명하는 열이 약 2만 개에 이를 수 있다. 열이 2만 개라는 사실이 변화의 원인도 2만 개라는 뜻은 아니다.
이 식은 유일한 정답 상태가 존재한다는 증명이 아니다. 가역 함수 $h$로 좌표를 바꿔 $z'=h(z)$, $g'=g\circ h^{-1}$로 두면 관측값은 동일하다. 복원을 완벽하게 해도 첫 번째 축이 “신뢰”, 두 번째 축이 “성숙도”라고 정해지지 않는다. 축에 의미를 붙이려면 독립적인 측정이나 추가 가정이 필요하다. 이런 식별 가능성 문제는 Locatello 등의 비지도 표현 학습 연구에서도 중요한 주제다.
2D 장면을 하나 정하자. 점들이 처음에는 오른쪽으로 함께 움직이다가, 어느 시점 이후 위와 아래로 갈라진다. 가로 좌표는 진행 정도, 세로 좌표는 갈라지는 방향이다. 데이터 생성기는 이 두 값을 비선형으로 섞고 잡음을 더해 24개 관측 특징을 만든다. 학습기는 이 24개 특징을 받는다. 생성기의 정답 좌표는 받지 않는다.
다섯 질문을 분리한다
전체 과정의 중심축은 다음과 같다.
$$ \boxed{x\rightarrow z\rightarrow\text{trajectory}\rightarrow\text{dynamics}\rightarrow\text{fate}}. $$표현 학습은 상태에 어떤 정보를 남길지 묻는다. 기하는 어떤 상태들이 가까운지 묻는다. 경로 추론은 그 상태들을 어떻게 연결하고 어디에서 분기시킬지 묻는다. 동역학은 주어진 시간 간격 동안 상태가 어떻게 변하는지 묻는다. 최종 결과 예측은 지금 이용할 수 있는 정보로 어떤 끝에 도달할 가능성이 큰지 묻는다.
점구름이 Y 모양이라고 해 보자. 이 모양은 분기하는 구조를 제안한다. 하지만 한 집단이 두 집단으로 갈라졌는지, 두 집단이 합쳐졌는지, 서로 다른 과정이 우연히 같은 모양으로 놓였는지는 결정하지 못한다. 시작점 표지, 수집 시각, 같은 개체의 연속 관측, 계보 추적 같은 추가 정보가 방향의 근거가 될 수 있다. 분석자는 자신이 어떤 근거를 사용했는지 밝혀야 한다.
의사시간(pseudotime)은 제안한 경로를 따라 매긴 순서이고, 실제 시간은 시계로 측정한 값이다. 어떤 구간에 점이 많다는 사실도 이동이 느리다는 뜻으로 바로 해석할 수 없다. 더 자주 표본을 수집했거나 세포가 증식했기 때문일 수 있다. 표본 밀도만으로는 이 설명들을 구분하지 못한다. 이 문제는 나중에 개체 경로와 집단 수송을 비교할 때 다시 등장한다.
열두 강의가 공유할 데이터
생성기는 120개 세션을 만들며 각 세션에는 순서가 있는 관측 16개가 있다. 한 행은 한 번의 관측이고, 한 세션은 연결된 시퀀스다. X에는 측정 특징을, time, session, next_index에는 관측의 시간과 연결 정보를 둔다. branch와 z_true는 생성기의 정답이므로 명시적인 평가나 정답을 알고 그리는 그림에만 사용한다.
후반부에는 세션별 결과와 무작위 처치 정보도 이용한다. 이 열들을 몰래 X에 붙이지 않는다. 기준선 변수는 처치 이전에 측정한다. 이러한 역할 구분이 있어야 현재 상태를 예측하는 모델에 미래의 결과가 섞이는 일을 막을 수 있다.
학습과 평가도 세션 전체를 기준으로 나눈다. 같은 세션의 이웃한 두 시점을 무작위로 나누면, 평가할 장면과 거의 같은 장면을 이미 학습했을 수 있다. 이번 분할은 90개 학습 세션과 30개 평가 세션이다. 실제 서비스에서 새로운 사용자에게 일반화하려면 사용자 단위 분할이 필요할 수 있다. 세포 연구에서는 공여자 단위 분할이 적절할 수 있다. 새로 만나게 될 단위와 평가에서 숨기는 단위를 맞추자. 구현에 쓸 수 있는 도구는 scikit-learn의 그룹 교차 검증 문서에 정리되어 있다.
첫 번째 데이터 점검을 실행한다
압축을 푼 실습 디렉터리에서 다음 코드를 실행한다.
from pathlib import Path
from lesson01 import run

metrics = run(Path("outputs"))
print(metrics)
전체 코드는 학습 세션으로만 전처리와 PCA를 적합한 뒤 모든 관측을 변환한다. 그리고 평가 세션 하나를 기록된 시간순으로 그린다. 학습과 평가에 같은 세션 ID가 없는지, 유효한 다음 관측이 같은 세션에 속하는지, 다음 관측의 시간이 증가하는지도 확인한다. 이는 데이터의 약속을 검증하는 절차다. PCA가 생물학을 복원했다는 검증과는 다르다.
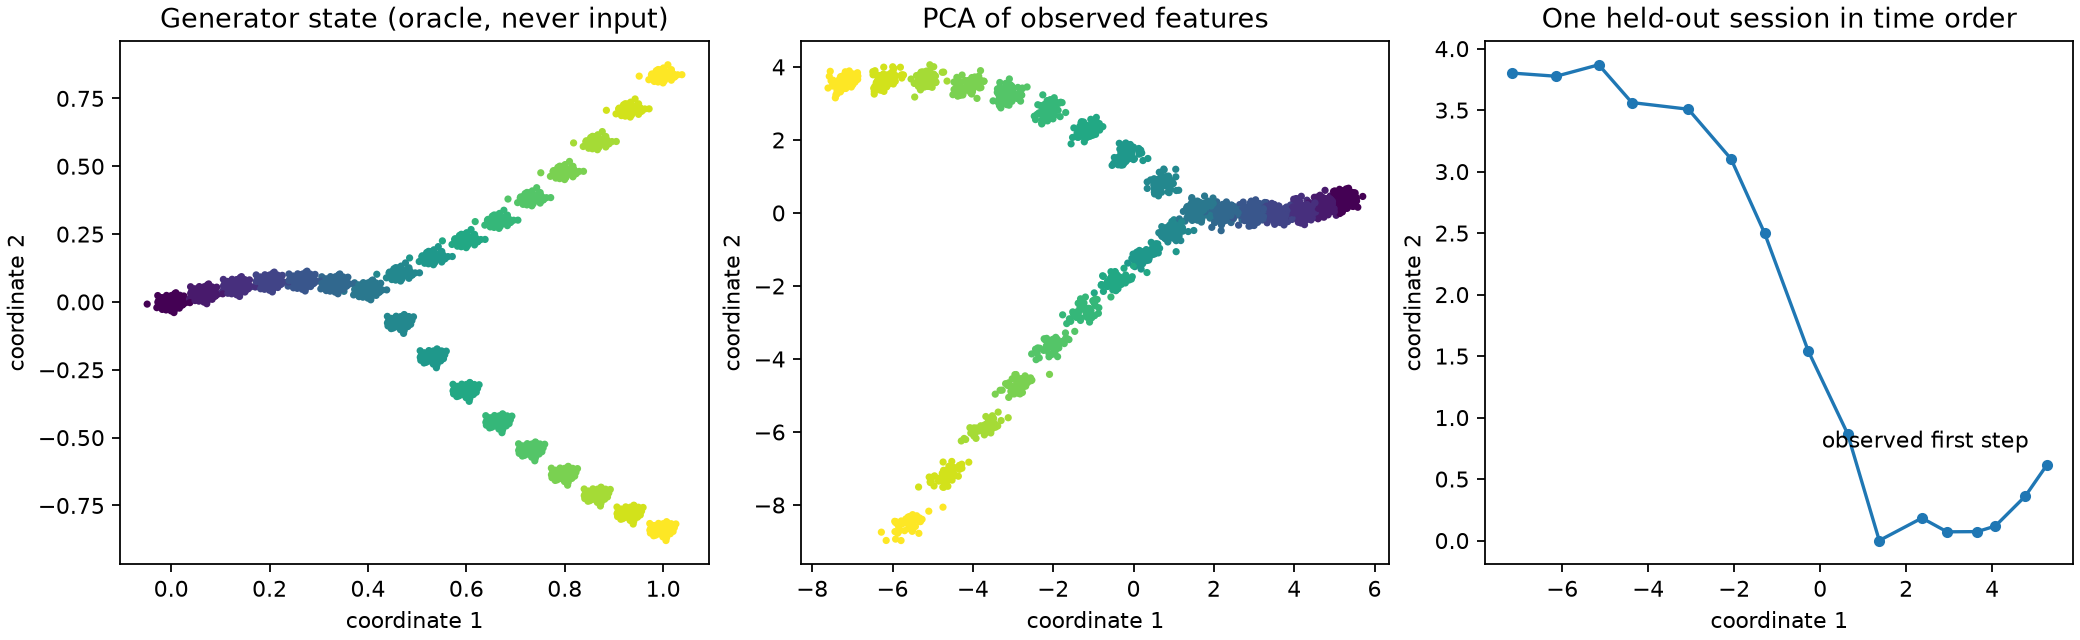
첫 번째 그림은 z_true를 일부러 보여 주는 정답 참조 그림이다. 두 번째는 관측값으로 배운 좌표다. 둘 다 유용한 구조를 드러내더라도 축 방향과 숫자가 같을 필요는 없다. 색은 실제 기록 시간을 보여 주지만 PCA 학습에 시간을 넣지는 않았다. 세 번째 그림은 순서 없는 스냅샷에 없던 시퀀스 정보를 사용한다.
코드는 행 순서를 섞은 뒤 특징 평균도 비교한다. 부동소수점 오차를 제외하면 평균은 변하지 않는다. 같은 점들의 집합이라는 정보도 유지된다. 그 집합에 부여하는 시간 방향을 뒤집어도 점구름은 그대로다. 스냅샷만으로 방향이 결정되지 않는다는 주장을 작게 실행해 보는 실험이다.
바이오와 캐릭터 대화의 공통점과 차이
많은 단일세포 측정은 측정 과정에서 세포를 소모한다. 따라서 두 시각의 세포 데이터는 같은 세포를 다시 찍은 사진이 아닐 수 있다. 두 집단을 연결하려면 집단에 관한 가정이나 계보 정보가 필요하다. “이 세포가 저 세포가 되었다”는 주장은 “발달의 연속체를 이루는 듯하다”보다 강한 주장이다.
캐릭터 대화는 턴 순서가 남아 있는 경우가 많다. 하지만 한 턴이 고정된 시간은 아니다. 짧은 20턴과 긴 20턴은 실제 경과 시간과 이야기 진행량이 다를 수 있다. 문맥 창을 겹쳐 만들면 이웃 관측이 입력의 상당 부분을 공유한다. 상태 전이를 학습하기 전에 관측 단위, 문맥 창, 시간 단위를 먼저 정해야 한다.
두 분야는 수학 도구를 공유하지만 측정 과정까지 같지는 않다. 대화 임베딩 차분은 RNA velocity가 아니며, 세포 군집이 곧 캐릭터의 의도에 대응하지도 않는다. 두 예제를 함께 배우는 이유는 관측한 것과 추론한 것을 구분하는 습관을 얻기 위해서다.
연습과 해설
- 세션의 시간 방향을 뒤집어라. 점은 그대로 두고 연결 순서만 뒤집으면 무엇이 바뀌는가? 해설: 방향 있는 전이는 바뀌지만 평균과 무방향 기하는 바뀌지 않는다. 스냅샷만 보는 추정기는 추가 가정 없이 둘 중 하나를 고를 수 없다.
- 입력 열을 감사하라. 세 번째 턴에서 이탈을 예측할 때 “최종 세션 길이”를 넣어도 되는가? 해설: 그 시점에 알 수 없는 미래 정보이므로 일반적으로 안 된다. 현재까지의 턴 수는 다른 변수지만, 수집 방식이나 검열과 연결되어 있는지도 확인해야 한다.
- 일반화 대상을 정하라. 세션 단위 분할이면 새로운 사용자에 대한 일반화도 검증한 것인가? 힌트: 한 사용자가 여러 세션을 만든다. 그 주장을 하려면 사용자를 통째로 분리하고, 캐릭터가 두 집합에 어떻게 공유되는지도 보고한다.
이번 강의의 제출물은 그림 하나와 짧은 주장 기록이다. 그림이 직접 보여 준 것, 추가로 추론한 것, 그 추론을 확인할 측정을 각각 적는다. 다음 강의에서는 PCA를 통해 첫 번째 상태 표현을 정확한 수학으로 정의한다.