PCA는 데이터의 변동을 최대한 보존하는 평평한 좌표계를 고른다. 첫 번째 상태 표현으로 좋은 이유는 목적식이 명확하고, 해를 들여다볼 수 있으며, 실패하는 상황도 쉽게 만들 수 있기 때문이다.
두 특징이 거의 함께 증가한다고 하자. 산점도는 대각선으로 긴 구름이 된다. 두 좌표를 모두 기록하면 비슷한 정보를 중복해서 담는다. 긴 축을 따라 어디에 있는지만 기록하면 변동의 상당 부분을 남길 수 있다. 그 축에서 수직으로 떨어진 거리가 압축하면서 잃는 정보다. PCA는 이 선택을 수식으로 만든다.
준비와 90분 구성
행렬 곱, 내적, 미분의 기본 개념이 필요하다. 고유벡터는 이 강의에서 소개한다. 2D 구름 15분, 목적식 유도 30분, SVD 연결 15분, 실습 20분, 해석 10분으로 구성한다. 제출물은 차원 수에 따른 복원 오차 곡선과 차원 선택의 근거다.
환경 안내, 전체 코드 묶음, lesson02.py를 이용한다. 1강과 같은 합성 세션을 계속 사용한다.
먼저 중심을 옮긴다
학습 관측값을 행으로 쌓아 $X\in\mathbb R^{n\times D}$를 만든다. 학습 평균을 $\mu$라고 하면 중심화한 행렬과 표본 공분산은 다음과 같다.
$$ X_c=X-\mathbf1\mu^\top,\qquad S=\frac1{n-1}X_c^\top X_c. $$대각 원소 $S_{jj}$는 특징 $j$의 표본 분산이다. 비대각 원소 $S_{jk}$는 두 특징의 공분산이다. 평균에서 뺀 두 특징이 함께 양수이거나 함께 음수인 경우가 많으면 양의 공분산이 나온다. 공분산에는 단위가 있으므로 숫자 단위가 큰 특징이 결과를 지배할 수 있다.
작은 예를 직접 계산해 보자.
$$ S=\begin{bmatrix}4&3\\3&4\end{bmatrix}. $$$(1,1)/\sqrt2$ 방향의 분산은 7이고, $(1,-1)/\sqrt2$ 방향의 분산은 1이다. 첫 방향 하나만 남겨도 전체 분산의 $7/8$을 보존한다. 두 행렬-벡터 곱으로 직접 확인할 수 있다. 공분산 행렬을 곱해도 방향은 유지되고 길이만 바뀌는 벡터를 고유벡터라고 부른다. 식으로 쓰면 $Sw=\lambda w$다.
중심화하지 않으면 구름 내부의 변동보다 원점에서 구름까지의 방향이 중요한 것처럼 보일 수 있다. 스케일링은 중심화와 별개의 선택이다. 이번 실습은 각 특징을 학습 평균과 표준편차로 표준화한다. 따라서 원래 단위의 복원 오차가 아니라 표준화된 단위의 복원 오차를 최적화한다. PCA 자체는 중심화만 하고 특징별 스케일을 맞추지는 않는다.
복원 오차에서 PCA를 유도한다
$W\in\mathbb R^{D\times d}$의 열에 서로 직교하고 길이가 1인 방향 $d$개를 담는다. 따라서 $W^\top W=I_d$다. 관측을 $Z\in\mathbb R^{n\times d}$로 압축하고 $ZW^\top$로 복원한다.
$$ \min_{W,Z}\|X_c-ZW^\top\|_F^2 \quad\text{subject to }W^\top W=I_d. $$$W$를 고정하고 $Z$에 대해 미분하면 최적 점수는 $Z=X_cW$다. 복원값은 $X_cWW^\top$가 되며, 이는 선택한 부분공간으로의 직교 투영이다. 목적식에 대입하면
$$ \|X_c-X_cWW^\top\|_F^2 =\|X_c\|_F^2-\operatorname{tr}(W^\top X_c^\top X_cW) $$를 얻는다. 첫 항은 고정되어 있으므로 잃는 에너지를 최소화하는 일은 남기는 분산을 최대화하는 일과 같다.
한 축이라면 제약 $w^\top w=1$ 아래 $w^\top Sw$를 최대화한다. 라그랑주 승수를 적용하면 $Sw=\lambda w$가 나온다. 가장 큰 고유값에 해당하는 고유벡터가 최대값을 만든다. 다음 축은 앞선 축에 직교하면서 그다음 큰 고유값을 택한다.
앞의 2D 예에서는 한 축을 남길 때 분산 1을 버린다. 두 축을 모두 남기면 복원 오차는 0이다. 하지만 모든 차원을 보존해 학습 오차가 0이 되었다고 해서 유용한 상태를 발견한 것은 아니다. 잡음을 포함해 입력을 모두 남겼다는 뜻일 뿐이다.
SVD는 같은 해를 다른 행렬에서 구한다
중심화한 데이터 행렬을 직접 분해하자.
$$ X_c=U\Sigma V^\top. $$그러면 $X_c^\top X_c=V\Sigma^2V^\top$다. 따라서 오른쪽 특이벡터의 상위 $d$개가 PCA 방향이며, 점수는 $Z=U_d\Sigma_d$, 설명 분산은 $\lambda_j=\sigma_j^2/(n-1)$이다. SVD와 PCA는 외워야 할 별도 요령이 아니라 같은 중심화 데이터에 대한 연결된 연산이다.
최적 랭크 $d$ 복원의 제곱 오차는 버린 특이값의 제곱합이다.
$$ \|X_c-X_{c,d}\|_F^2=\sum_{j>d}\sigma_j^2. $$이 등식은 구현 점검에 유용하다. 실습은 직접 구한 복원 오차와 버린 특이값 에너지가 일치하는지 확인하고, SVD 투영과 scikit-learn 투영도 비교한다. 고유벡터 원소 자체보다 투영 결과를 비교하자. 벡터 부호를 뒤집어도 같은 부분공간이며, 고유값이 같으면 그 공간 안의 회전도 가능하기 때문이다.
Python 구현과 평가
다운로드 코드의 핵심은 다음과 같다.
from common import make_dataset
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

data = make_dataset()
train = data["train"]
scaler = StandardScaler().fit(data["X"][train])
X = scaler.transform(data["X"])
pca = PCA(n_components=2, svd_solver="full").fit(X[train])
Z = pca.transform(X)
reconstruction = pca.inverse_transform(Z)
print(((X[~train] - reconstruction[~train]) ** 2).mean())
전체 스크립트는 차원을 1부터 24까지 바꾸며 복원 곡선을 그린다. 묶음을 푼 디렉터리에서 python lesson02.py --output outputs를 실행한다.
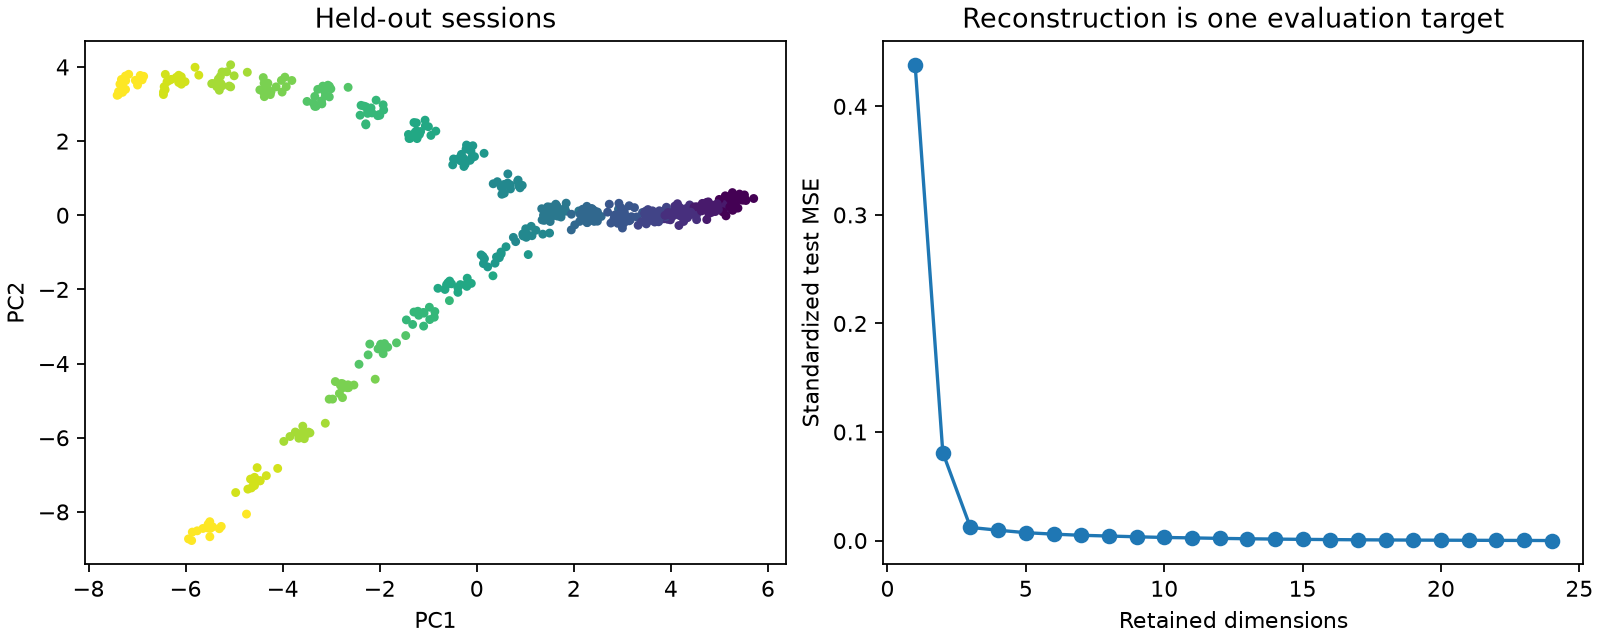
분할 전에 전체 데이터로 표준화하면 평가 집합의 분포가 학습에 섞인다. 레이블을 사용하지 않아도 전체 행으로 PCA를 적합하면 같은 문제가 생긴다. 이 수업은 학습 세션에서 좌표계를 고정하고 새로운 세션을 그 좌표계에 넣는 평가를 한다.
차원별 평가 곡선은 압축을 이해하기 위한 진단이다. 실제 연구에서 그 곡선을 여러 번 보고 모델을 고른 뒤 같은 데이터를 “한 번도 보지 않은 최종 평가”라고 부르면 안 된다. 차원 수는 학습 내부 교차 검증이나 별도 검증 집합으로 선택하고, 최종 절차를 평가 집합에 한 번 적용한다.
오차 단위도 밝혀야 한다. 위 inverse_transform은 표준화된 관측 공간으로 돌아간다. 원래 단위로 복원하려면 그다음에 스케일러의 역변환을 적용한다. 두 단위에서 계산한 MSE는 숫자도 의미도 다르다.
축에 이름을 붙이기 전에
유전자 발현의 큰 변동 축은 분화일 수도 있지만 라이브러리 크기, 세포 주기, 실험 배치일 수도 있다. PCA는 과학적으로 관심 있는 요인을 알지 못한다. 카운트에 맞는 전처리와 실험 메타데이터가 먼저 필요하다. 로딩과 독립적인 표지 유전자를 확인한 뒤 축을 해석한다. 매끄럽다는 이유만으로 PC1을 발달 시간이라고 부르지 않는다.
캐릭터 대화에서는 협력과 대립을 가르는 축이 나올 수도 있고, 단순히 메시지 길이를 가르는 축이 나올 수도 있다. 어떤 특징의 로딩이 크다는 것은 그 선형 축을 구성하는 데 크게 기여한다는 뜻이다. 그 특징이 이야기 결과의 원인이라는 뜻은 아니다. 문맥 창과 특징 스케일의 선택은 PCA를 돌리기 전부터 답을 바꾼다.
PC3에서 구분되는 분기는 2D 그림에서 겹칠 수 있다. 시각화 차원과 분석 차원을 별도로 선택하자. 설명 분산이 높다는 것은 이 목적식 아래 잘 압축했다는 증거다. 결과 예측에 중요한 신호까지 보존했다는 증거는 아니다.
연습과 확인
- 2D 예제를 계산하라. 두 단위 방향에 공분산 행렬을 곱해 보자. 정답: 고유값은 7과 1, 첫 축의 설명 분산 비율은 $0.875$, 버린 분산은 1이다.
- 측정 단위를 바꿔라. 한 원시 특징에 100을 곱하고 표준화 유무에 따라 PCA를 비교한다. 힌트: 원시 공분산에서는 그 특징의 영향이 크게 증가한다. 표준화하면 부호나 수치 오차를 제외하고 같은 결과를 기대한다.
- 작지만 중요한 신호를 생각하라. 결과가 저분산 축에만 의존한다면 분산 95% 보존으로 충분한가? 해설: 아니다. 표현 학습 목적과 예측 목적이 다를 수 있다. 95%를 만능 기준으로 삼지 말고 올바른 분할로 후속 과제를 평가한다.
PCA는 무엇을 보존하는지 정확히 말할 수 있어서 강한 기준선이 된다. 다음 강의에서는 복원을 출발점으로 유지하면서 지도 모양을 선형에서 비선형으로 바꾼다.