Clustering은 복잡한 관측을 몇 개의 상태 이름으로 다룰 수 있게 합니다. 그렇다고 자연이나 이야기 속에 정확히 그 개수의 상태가 존재한다고 증명하지는 않습니다. 연속적인 trajectory에도 실용적인 구간을 나눌 수 있으며, 그 경계가 원래부터 날카로울 필요는 없습니다.
선수 지식: PCA, 거리, 5강의 가중 그래프. 90분 구성: 장난감 예제 15분, 거리 기반 군집 20분, modularity와 community detection 20분, Python 25분, 해석 10분. 목표는 군집 방법의 가정을 설명하고, 설정 변화에 대한 민감도를 확인하고, 집단 발견과 의미 부여를 구분하는 것입니다.
공통 실습 안내, lesson06.py, 전체 실습 묶음을 사용합니다. lesson05.py의 그래프 함수도 함께 필요합니다.
1. 같은 점들에서도 집단이 다르게 보인다
2차원 평면에 조밀한 두 점구름을 그리고, 사이를 드문드문 놓인 점으로 연결합니다. 가장 가까운 중심을 찾는 방법은 가운데 어딘가에서 평면을 나눕니다. 밀도를 보는 방법은 연결 구간을 noise로 분류할 수 있습니다. 그래프 방법은 집단 내부의 연결이 기대보다 강한지를 묻습니다. 질문이 다르므로 결과가 다르다고 곧바로 버그라고 할 수는 없습니다.
점구름을 초승달 모양 두 개로 바꾸면 어떨까요? 중심까지의 거리로 나누는 경계는 초승달을 가로지를 수 있습니다. 이웃 간 연결은 휘어진 모양을 따라갈 수 있습니다. 반대로 하나의 긴 곡선에 6개 군집을 요청하면, 원래 여섯 종류가 없는 데이터에서도 여섯 개 라벨이 생깁니다.
알고리즘을 선택하는 일은 어떤 모양의 집단을 찾을지 정하는 일입니다. 실습 결과를 비교할 때 이 세 장면을 떠올려 보세요.
2. 거리와 밀도로 나누는 네 가지 방법
k-means는 $K$개의 중심과 할당을 정해 다음 값을 줄입니다.
$$\min_{c,\mu}\sum_i\|r_i-\mu_{c_i}\|^2.$$가장 가까운 중심으로 점을 할당하고, 각 중심을 소속 점들의 평균으로 바꾸는 일을 반복합니다. 목적함수는 증가하지 않지만 초기값에 따라 다른 지역 최적해에 도달할 수 있어 여러 초기화를 시도합니다. 큰 단위의 특성이 거리 제곱을 지배하므로 스케일링도 중요합니다. 조밀하고 중심 주변에 모인 집단에 잘 맞으며, 새 점도 가장 가까운 중심으로 바로 할당할 수 있습니다.
**계층적 군집화(hierarchical clustering)**는 점 하나씩에서 출발해 집단을 합칩니다. 무엇을 합칠지는 linkage가 결정합니다. Ward linkage는 집단 내부 제곱오차의 증가가 가장 작은 병합을 고릅니다. Single linkage는 가장 가까운 점 쌍을 보므로 가느다란 연결을 따라 길게 이어질 수 있습니다. Dendrogram은 여러 해상도의 분할을 보여주지만, 어느 높이에서 자를지는 여전히 선택해야 합니다.
DBSCAN은 반경 $\varepsilon$ 안에 관측이 충분히 있는 점을 core로 정합니다. 밀도로 연결된 core들이 집단을 이루고, 주변 border point가 합류하며, 남은 점에는 -1이라는 noise 라벨을 붙입니다. 반경과 최소 관측 수가 핵심 설정입니다. 집단별 밀도가 크게 다르면 하나의 반경으로 모두 설명하기 어렵습니다.
HDBSCAN은 여러 밀도 수준의 계층을 살펴보고 지속되는 집단을 선택합니다. 최소 군집 크기 등의 선택은 여전히 필요하며 noise도 허용합니다. 하나의 반경에 대한 의존을 줄일 뿐, 매개변수 없는 방법은 아닙니다. 목적함수와 구현 차이는 scikit-learn 군집화 가이드에서 확인할 수 있습니다. 기본 실습은 DBSCAN을 실행하고 HDBSCAN은 확장 과제로 둡니다.
3. Modularity는 예상보다 강한 연결을 찾는다
5강의 대칭 유사도 $W$를 재사용합니다. $d_i=\sum_jW_{ij}$, $2m=\sum_i d_i$라 하면 community 라벨 $c_i$의 modularity는
$$Q=\frac{1}{2m}\sum_{ij}\left(W_{ij}-\gamma\frac{d_id_j}{2m}\right)\mathbf1[c_i=c_j]$$입니다. 첫 항은 집단 내부에서 실제 관찰한 연결 강도입니다. 둘째 항은 degree를 기준으로 한 null model이 기대하는 연결 강도입니다. Resolution $\gamma$를 높이면 일반적으로 더 작은 집단이 선호되지만, 특정 군집 수를 보장하지는 않습니다.
약한 간선 하나로 이어진 삼각형 두 개를 생각해 보세요. 각 삼각형에는 강한 내부 연결 세 개가 있습니다. 전체 그래프가 연결되어 있어도 두 삼각형으로 나누면 내부 연결이 기대치를 넘어설 수 있습니다. 원래 간선이 많은 점이 자주 연결되는 것은 당연하므로 degree 보정이 필요합니다.
Modularity에는 해상도 한계가 있고, 점수가 비슷하게 높은 분할도 여러 개 존재합니다. 특정 그래프에서 점수가 높다는 사실이 생물학적으로 옳다는 증거는 아닙니다. Resolution이 다르면 목적함수도 달라지므로 점수를 같은 척도처럼 직접 비교하지 않습니다.
4. Louvain과 Leiden은 무엇이 다른가
Louvain은 작은 community에서 출발해 목적함수가 좋아지는 방향으로 점을 옮깁니다. 이후 집단을 하나의 큰 노드로 합치고 다시 반복합니다. 빠른 휴리스틱이지만 전역 최적화를 보장하지 않습니다. 가중치와 resolution 인자는 NetworkX Louvain 문서에 설명되어 있습니다.
Louvain은 내부 연결이 약하거나 끊긴 community를 반환할 수도 있습니다. Leiden은 집약 전에 refinement 단계를 추가해, 알고리즘과 목적함수의 조건 아래 더 강한 연결성 보장을 제공합니다. 모든 해상도 문제를 해결하거나 전역 최적 분할을 인증하는 것은 아닙니다. Leiden 원논문은 한 번의 반복, 변화가 멈춘 반복, 수렴 이후의 보장을 구분합니다. 이번 코드는 의존성을 단순하게 유지하기 위해 Louvain을 실행합니다. 결과를 Leiden이라고 부르지 않습니다.
5. Python: 하나를 고르기 전에 비교하고 흔들어 보기
전체 코드는 PCA 6축에서 k-means, Ward, DBSCAN, Louvain을 실행합니다. 그림은 첫 두 축만 보여주므로, 겹쳐 보이는 점이 다른 축에서는 분리되어 있을 수 있습니다.
from common import make_dataset, prepare_embedding
from lesson05 import affinity_graph
from lesson06 import community_labels
import networkx as nx
from sklearn.metrics import adjusted_rand_score

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
G = nx.from_scipy_sparse_array(affinity_graph(Z))
labels, groups = community_labels(G, resolution=1.0)
finer, _ = community_labels(G, resolution=2.0)
print(len(groups), adjusted_rand_score(labels, finer))
python lesson06.py --output outputs로 실행합니다. Adjusted Rand index, ARI는 우연 일치를 보정한 두 분할의 유사도입니다. 라벨 이름은 필요하지 않습니다. 여기서는 정답과의 일치가 아니라 resolution 변화에 대한 민감도를 나타냅니다.
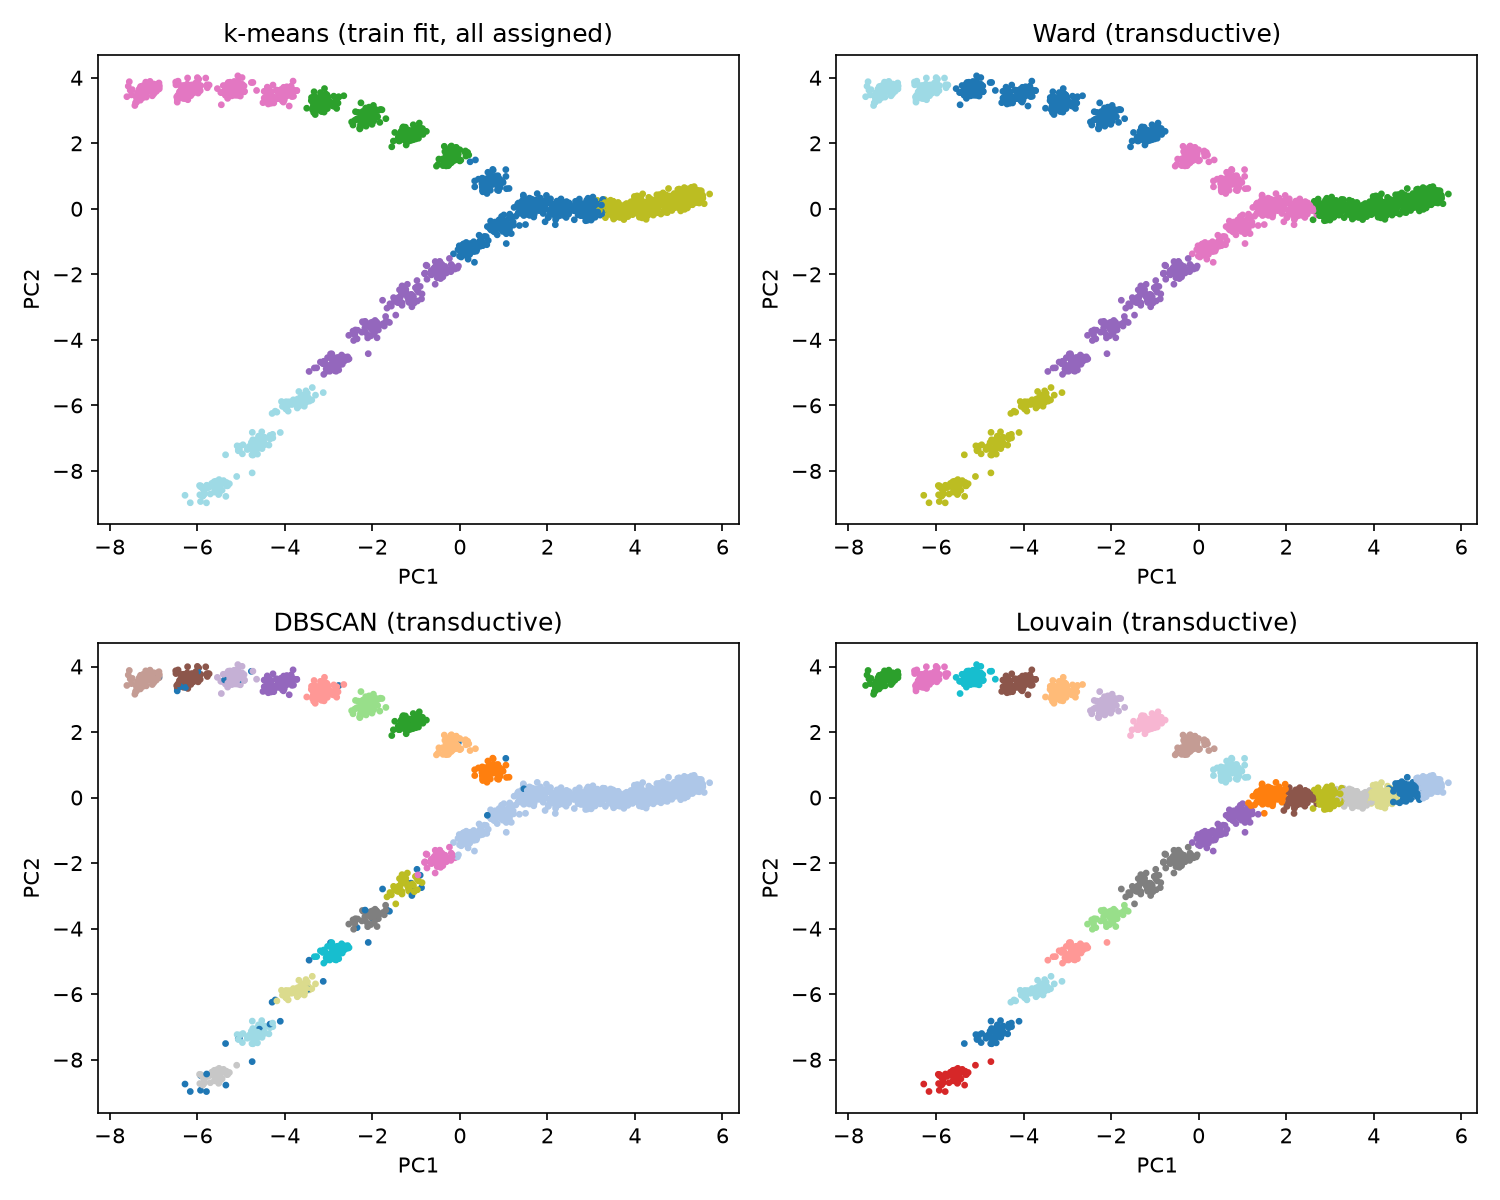
스케일러, PCA, k-means 중심은 학습 세션으로만 적합합니다. 평가 세션의 중심까지 거리 제곱은 기하학적 진단으로 보고합니다. Ward, DBSCAN, Louvain은 모든 관측을 함께 보므로 transductive 분석입니다. 보기 좋은 그림을 평가 데이터의 분류 정확도로 해석하면 안 됩니다. Seed, 이웃 수, 세션 단위 재표집을 바꾸어도 결과가 유지되는지 확인하세요.
6. 세포 상태와 이야기 상태에 이름 붙이기
세포에서는 marker 발현, batch 구성, 다른 donor에서의 반복을 확인하고 이름을 붙입니다. 특정 batch에만 있는 집단은 측정 과정의 차이일 수 있습니다. 알려진 cell type 사이에서도 실제 경로는 연속적일 수 있으므로 경계는 편의를 위한 근사일 수 있습니다.
캐릭터 채팅에서는 각 집단의 대화 구간을 표집하고, 명시적인 annotation 기준으로 검토합니다. “신뢰 형성”, “갈등 고조”라는 이름에는 실제 텍스트 근거가 필요합니다. 화자 정체성, 언어, 구간 길이가 집단을 설명할 수도 있습니다. 라벨은 사용자의 내면에 대한 심리 진단이 아닙니다.
수업에는 합성 데이터나 사용에 동의한 대화를 이용합니다. 같은 사용자나 세션이 학습과 평가에 나뉘지 않게 하고, 나중에 온라인 예측을 할 목적이라면 미래 턴을 읽는 인코더를 사용하지 않습니다.
7. 연습문제와 힌트
- DBSCAN의 noise는 나쁜 데이터인가요? 선택한 밀도 기준에 맞지 않는다는 뜻입니다. 드문 전이 구간은 오히려 중요할 수 있으므로 삭제 전에 살펴봅니다.
- Resolution을 올려 상태 수가 두 배가 되면 어느 쪽이 맞나요? 개수만으로 결정할 수 없습니다. 안정성, downstream task의 유용성, 독립적인 annotation을 비교해야 합니다. Resolution은 질문 자체를 바꿉니다.
- “갈등” community를 검증하는 실험을 설계하세요. 해당 집단과 다른 집단에서 조건을 맞춘 구간을 표집해 라벨을 가리고 annotation합니다. 일치도와 언어·캐릭터 같은 교란 요인을 보고합니다. 이름을 뒷받침하는 예시만 고르면 안 됩니다.
다음 강의에서는 이렇게 나눈 영역을 경로로 연결하고, 그 경로를 trajectory라고 부르기 위해 어떤 가정이 필요한지 살펴봅니다.