관측 사이에 그린 경로는 진행 과정에 대한 기하학적 가설입니다. 이를 세포 발달이나 이야기의 변화로 해석하려면 출발점을 정하고, 갈림길을 검증하고, 왜 이 관측들이 그 순서를 뒷받침하는지 설명해야 합니다. Snapshot의 모양만으로는 시계도 인과적 방향도 얻을 수 없습니다.
선수 지식: PCA, 이웃 그래프, clustering, 최단 경로. 90분 구성: 분기 예제 15분, MST 15분, principal curve와 graph 20분, PAGA 15분, 실습과 해석 25분. 목표는 가장 짧은 트리, 데이터에 적합한 곡선, 집단 간 연결 그래프, 실제 시계열을 구분하는 것입니다.
공통 실습 환경, lesson07.py, 전체 실습 묶음을 사용합니다.
1. 하나의 줄기, 두 개의 다음 이야기
2차원 평면에 가로로 점을 놓다가 위와 아래로 갈라지는 Y 모양을 그려봅시다. 이제 수집 순서를 숨깁니다. Clustering은 영역을 나누지만, 라벨만으로는 어느 영역끼리 이어지는지, 어디서 시작하는지 알 수 없습니다.
몇 개의 대표점을 지나는 트리를 만드는 것은 명확한 출발점입니다. 이 트리는 후보 갈림길을 보여주며, 개별 관측의 실제 이동 기록이라고 주장하지 않습니다. 그림에 고리를 하나 넣으면 한계도 바로 드러납니다. 트리는 반드시 고리의 어느 연결을 끊어야 합니다. 알고리즘에는 topology에 대한 가정이 들어 있습니다.
공통 프로젝트에는 여러 step에서 관측한 분기 세션이 있습니다. 이번 강의는 경로를 적합할 때 세션 내부 전이를 일부러 숨깁니다. 점들의 기하학으로 baseline을 만들고, 남겨 둔 관측 시간으로 결과를 진단합니다. 실제 순서 정보는 8강에서 사용합니다.
2. Minimum Spanning Tree라는 명확한 baseline
대표점 $\mu_1,\ldots,\mu_K$ 사이의 비용을
$$w_{ab}=\|\mu_a-\mu_b\|_2$$로 정합니다. 모든 대표점을 연결하는 트리 중 총비용이 가장 작은 것을 고릅니다.
$$T^*=\arg\min_T\sum_{(a,b)\in T}w_{ab}.$$트리에는 간선이 $K-1$개 있고, 고리가 없으며, 두 점 사이 경로가 하나입니다. Kruskal 알고리즘은 비용이 작은 간선부터 보면서 고리를 만들지 않는 간선만 추가합니다. 학부 자료구조·알고리즘에서 배운 트리가 ML의 경로 복원으로 연결되는 지점입니다.
여기서 가중치는 거리입니다. 유사도가 아닙니다. 유사도 가중치를 최소화하면 약한 연결을 우선 선택하게 됩니다. Sparse 이웃 그래프에서 시작한다면 간선 길이를 사용하며, 그래프가 끊겨 있으면 하나의 spanning tree가 아니라 forest가 나온다는 점도 확인합니다. SciPy 그래프 문서는 MST와 최단 경로 기능을 제공합니다.
잡음이 있는 모든 점에 트리를 만들면 이상치를 따라갈 수 있습니다. 실습은 학습 세션에서 k-means 대표점 14개를 구하고, 대표점 사이의 완전 유클리드 그래프에 MST를 만듭니다. 완전 그래프는 트리를 보장하지만 큰 빈 공간을 억지로 건널 수도 있습니다. 유난히 긴 간선을 발견했다면 입증된 전이로 받아들이지 말고 조사해야 합니다.
3. Principal curve와 principal graph
Principal curve는 PCA의 직선을 데이터 가운데를 지나는 부드러운 곡선으로 확장합니다. 곡선을 $f(s)$, 관측 $x$에 가장 가까운 곡선 위치의 매개변수를 $s_f(x)$라 하면 고전적 principal curve의 자기일관성 조건은
$$f(s)=\mathbb E[X\mid s_f(X)=s]$$입니다. 곡선의 특정 위치로 투영되는 관측들의 평균이 그 위치와 같다는 뜻입니다.
직관적인 적합 방법은 데이터를 현재 곡선에 투영하고, 투영 위치에 따른 관측을 smoothing한 뒤 반복하는 것입니다. 부드러움에 대한 선택이 있어야 곡선이 잡음을 하나씩 꿰고 다니지 않습니다. 자기일관성이 진짜 발달 경로나 유일한 답을 보장하지는 않습니다. Hastie와 Stuetzle의 원논문에서 고전적 정의를 확인할 수 있습니다.
갈라지지 않는 곡선 하나는 Y 모양을 표현하지 못합니다. Principal graph는 분기점을 가진 노드와 간선으로 표현을 확장합니다. 수업용으로 다음 목적을 생각할 수 있습니다.
$$\sum_i d(r_i,G)^2+\lambda\,\operatorname{length}(G)+\eta\,\operatorname{complexity}(G).$$데이터에 가깝게 놓되 지나치게 길거나 복잡한 그래프를 막는 것입니다. 이것은 개념 설명용 목적식이며, 모든 principal graph 알고리즘의 공식은 아닙니다. 실제 방법들은 탄성, smoothing, topology 변경, 정규화가 다릅니다. 갈림길을 충분히 많이 만들면 잡음도 잘 맞추므로 복잡도 제어가 중요합니다. 다운로드 실습은 MST baseline이며 principal curve나 elastic graph 구현이 아닙니다.
4. PAGA는 집단 사이의 연결을 요약한다
PAGA는 관측의 이웃 그래프와 그 그래프의 분할에서 출발합니다. 각 집단을 큰 노드 하나로 바꾸고, 집단 사이의 연결이 무작위 연결의 기대치에 비해 얼마나 지지되는지 간선 가중치로 요약합니다. 약한 연결은 걸러낼 수 있습니다.
핵심 정보는 서로 다른 집단에 속한 관측 사이에 실제로 존재하는 이웃 간선입니다. 단순히 군집 중심 사이가 가까운지가 아닙니다. PAGA는 끊긴 구조와 트리가 아닌 구조를 유지할 수 있습니다. MST는 입력 그래프가 연결되면 트리를 강제합니다. 따라서 중심점 MST를 “PAGA”라고 부르면 알고리즘과 해석을 모두 바꾸게 됩니다.
PAGA 원논문은 통계적 연결 강도의 정의와 집단 수준 경로를 세포 수준 거리와 결합하는 방법을 설명합니다. Topology를 조사하는 도구이지, 남은 모든 간선이 실제 lineage라는 증명은 아닙니다. 군집 해상도와 이웃 구성에 따라 결과가 달라집니다.
5. Pseudotime에는 출발점이 필요하다
Root $r$와 길이 가중 그래프 $G$가 있으면 기본 pseudotime은
$$\tau_i=d_G(r,i)$$입니다. 같은 무방향 그래프에서도 root를 바꾸면 순서가 바뀝니다. 초기 marker, 알려진 시작 표본, 실험 설계가 root 선택을 뒷받침할 수 있습니다. 예상한 답이 나오는 root를 고른 뒤 같은 답과 일치한다고 독립 검증을 주장하면 순환논리가 됩니다.
실습에서는 관측을 가장 가까운 트리 간선 위에 투영하고, root부터 그 투영점까지의 거리를 계산합니다. 그래서 같은 군집에 속한 모든 점에 똑같은 값을 주지는 않습니다. 트리 바깥으로 얼마나 떨어져 있는지, 즉 투영 오차는 별도로 보고합니다.
Pseudotime의 단위는 임베딩 거리입니다. 좌표 스케일이 바뀌면 값도 달라집니다. 더 긴 branch가 더 많은 분을 필요로 한다는 뜻이 아니며, 서로 다른 branch에서 같은 값이라고 같은 생물학적 시점인 것도 아닙니다. 세포 주기의 고리도 이 트리 좌표로 충실하게 나타낼 수 없습니다.
6. Python과 root를 바꾸는 실험
전체 스크립트에서 사용하는 트리 구성은 다음과 같습니다.
from common import make_dataset, prepare_embedding
from sklearn.cluster import KMeans
from scipy.spatial.distance import cdist
from scipy.sparse.csgraph import minimum_spanning_tree

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
km = KMeans(n_clusters=14, n_init=10, random_state=7).fit(Z[data["train"]])
centers = km.cluster_centers_
tree = minimum_spanning_tree(cdist(centers, centers))
print(tree.nnz, len(centers) - 1)
python lesson07.py --output outputs로 실행합니다. 첫 root는 알려진 초기 학습 관측의 평균에 가장 가까운 대표점입니다. 두 번째 패널은 그 root에서 가장 먼 트리 노드를 시작점으로 바꿉니다. 별표는 각 패널에서 선택한 root를 표시합니다.
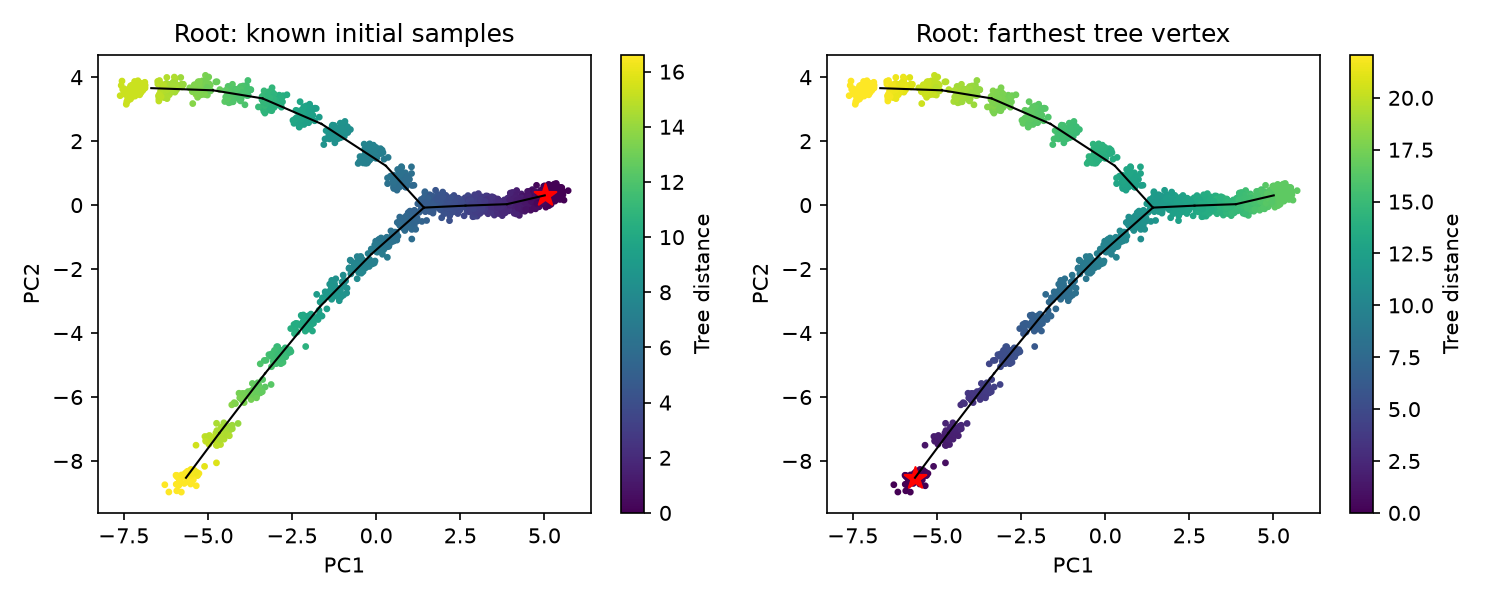
JSON은 평가 세션의 투영 오차와 관측 시간에 대한 Spearman 상관을 보고하고, 다른 root의 상관도 비교합니다. 표현과 트리 적합은 학습 세션만 사용하며 평가 관측은 나중에 투영합니다. 고정된 기하학적 복원의 진단이지, 미래 예측이나 올바른 조상 관계의 증거는 아닙니다. 합성 데이터의 숨은 정답 좌표는 적합에 쓰지 않습니다.
7. 세포와 이야기에서 무엇을 확인할까
세포에서는 발달 marker와 독립 표본으로 줄기와 갈림길을 검증합니다. 파괴적으로 측정하는 sequencing은 서로 다른 세포를 서로 다른 단계에서 보는 경우가 많습니다. 가깝다고 직접적인 부모·자손 관계가 되는 것은 아닙니다. Lineage tracing은 별도의 종류의 증거를 제공합니다.
채팅에서는 비슷한 이야기 상태에서 가능한 서로 다른 전개가 branch가 될 수 있습니다. 그러나 언어나 캐릭터별로 갈린 것이라면 이야기 변화보다 인코더의 특성을 반영할 수 있습니다. 대화에는 실제 턴 순서가 있으므로 추정 경로와 세션 내부 전이를 비교합니다. 온라인 적용에서는 분석 시점까지 존재하는 구간만 사용해야 합니다.
8. 연습문제와 해설
- MST 비용으로 affinity를 넣으면 왜 의도가 뒤집히나요? 작은 similarity는 덜 비슷하다는 뜻인데 최소화는 작은 가중치를 고릅니다. 길이나 정당화된 비용 변환을 써야 합니다.
- 수집 시간과 높은 상관이면 branch도 맞나요? 아닙니다. 시간 순서를 잘 맞추면서 잘못된 끝점들을 연결할 수 있습니다. Topology와 도메인 근거를 따로 평가합니다.
- 실제 경로에 고리가 있으면 어떻게 되나요? 트리는 적어도 연결 하나를 끊습니다. 고리를 허용하는 방법과 비교하고, 끊어진 곳을 발견된 생물학적 사건으로 해석하지 않습니다.
다음 강의에서는 관측된 순서를 이용해 기하학적 순서 대신 실제 전이확률을 추정합니다.