순서를 알면 “어떤 점들이 가까운가?”에서 “현재 상태 다음에 무엇이 오는가?”로 질문을 바꿀 수 있습니다. Markov model은 전이표로 답합니다. HMM은 상태 라벨 자체도 불확실하다는 사실을 모델에 넣습니다. State space model은 숨은 상태를 연속적인 벡터로 확장합니다.
선수 지식: 조건부확률, 행렬곱, clustering, 동적 계획법. 90분 구성: 시퀀스 예제 10분, Markov 추정 15분, HMM 추론 30분, 실습 20분, 연속 상태와 적용 15분. 목표는 세션 경계를 넘지 않고 전이를 세며, 각 추론 방법이 어떤 시점의 관측을 사용하는지 설명하는 것입니다.
공통 실습 환경, lesson08.py, 전체 실습 묶음을 사용합니다.
1. 짧은 시퀀스 두 개는 긴 시퀀스 하나가 아니다
두 세션의 상태가 각각 A, A, B와 C, C라고 합시다. 관측한 전이는 A→A, A→B, C→C입니다. B→C는 관측하지 않았습니다. 행을 이어 붙이고 인접한 모든 행을 세면 존재하지 않았던 전이가 만들어집니다.
2차원 그림에 A, B, C를 세 위치로 놓고 실제 관측한 화살표를 그립니다. 거리만으로 화살표의 방향과 확률은 정해지지 않습니다. 가까운 상태끼리 거의 이어지지 않을 수도 있고, 먼 상태로 자주 도약할 수도 있습니다. 5강의 유사도 기반 랜덤 워크와 본질적으로 다른 점입니다.
1차 Markov 가정은
$$P(s_{t+1}\mid s_t,s_{t-1},\ldots)=P(s_{t+1}\mid s_t)$$입니다. 현재 상태만 알면 과거를 더 알아도 다음 상태의 확률이 바뀌지 않는다는 모델 가정입니다. 차원 축소를 했다고 자동으로 성립하지는 않습니다. 표현이 필요한 과거 정보를 충분히 보존해야 유용한 근사가 됩니다. 이전 약속이나 미해결 사건을 기억하는 대화에서는 특히 강한 가정입니다.
2. 전이행렬 추정하기
학습 세션 안에서 $i$ 다음에 $j$가 나온 횟수를 $N_{ij}$라 합시다. 상태가 $K$개이고 모든 칸에 pseudocount $a>0$를 더하면
$$A_{ij}=\frac{N_{ij}+a}{\sum_jN_{ij}+Ka}$$입니다. 작은 표본에서 보지 못했다는 이유만으로 어떤 전이를 확률 0으로 만들지 않게 합니다. 그렇다고 그 전이가 물리적으로 가능하다고 증명하는 것은 아닙니다. 불가능하다고 알려진 전이가 있다면 구조적으로 금지하는 모델을 따로 지정해야 합니다.
각 행의 합은 1입니다. 행벡터 분포 $p_t$는 $p_{t+1}=p_tA$로 움직입니다. 시간에 따라 같은 행렬을 쓰고 step 간격도 같다면 $A^h$가 $h$ step 뒤의 전이를 나타냅니다. 채팅 한 턴과 한 시간은 다른 단위입니다. 간격이 불규칙하면 모두 같은 간격인 척하지 말고 추가 모델링이 필요합니다.
실습은 학습 관측으로 k-means를 적합하고, 그 중심에 모든 관측을 할당한 뒤 라벨 사이 전이를 셉니다. 이 라벨은 학습한 이산화 결과이며 정답 상태가 아닙니다.
3. HMM: 숨은 상태가 불확실한 관측을 만든다
숨은 상태를 $s_t\in\{1,\ldots,K\}$, 관측된 PCA 벡터를 $r_t$라 합시다. HMM은 초기분포 $\pi$, 전이행렬 $A$, 방출 밀도(emission density) $b_j(r)=p(r\mid s=j)$를 결합합니다.
$$p(s_{1:T},r_{1:T})=\pi_{s_1}b_{s_1}(r_1) \prod_{t=2}^TA_{s_{t-1},s_t}b_{s_t}(r_t).$$현재 숨은 상태가 주어지면 현재 관측은 다른 관측과 조건부 독립이라고 가정합니다. 연속 좌표에는 Gaussian emission을 간단한 baseline으로 쓸 수 있습니다. 확률밀도는 이산확률이 아니므로 값이 1을 넘을 수도 있습니다.
고정한 모델에서 시퀀스의 가능성을 평가하는 일, 숨은 상태를 추론하는 일, 모델의 매개변수를 학습하는 일은 구분해야 합니다. Rabiner의 원래 HMM 튜토리얼은 고전적 알고리즘을 이 세 문제로 정리합니다.
4. Forward, backward, Viterbi
Forward는 특정 상태로 끝나는 모든 과거 경로의 확률을 더합니다. $\alpha_t(j)=p(r_{1:t},s_t=j)$라 두면
$$\alpha_1(j)=\pi_jb_j(r_1),\qquad \alpha_t(j)=b_j(r_t)\sum_i\alpha_{t-1}(i)A_{ij}.$$시퀀스 likelihood는 $\sum_j\alpha_T(j)$입니다. 상태 경로를 하나씩 열거하면 지수적으로 많지만, 같은 끝 상태끼리 결과를 재사용하는 동적 계획법으로 dense 전이의 계산량은 $O(TK^2)$가 됩니다. 긴 시퀀스에서는 작은 확률의 곱이 underflow하므로 매 step 정규화하거나 log space에서 계산합니다.
Backward는 앞으로 남은 관측을 요약합니다. $\beta_t(i)=p(r_{t+1:T}\mid s_t=i)$로 정의하면
$$\beta_T(i)=1,\qquad \beta_t(i)=\sum_jA_{ij}b_j(r_{t+1})\beta_{t+1}(j).$$전체 시퀀스를 본 뒤의 상태확률, 즉 smoothed posterior는 $\alpha_t(i)\beta_t(i)$에 비례합니다. 시점 $t$ 이후 관측도 사용합니다. 반면 $\alpha_t$만 정규화한 filtered distribution은 현재까지의 관측만 사용합니다. 온라인 예측에 smoothed state를 그대로 넣으면 미래 정보가 새어 들어갑니다.
Viterbi는 시점별로 가장 유력한 상태를 따로 고르는 대신 전체 경로 하나의 확률을 최대화합니다. Log space에서는
$$\delta_t(j)=\log b_j(r_t)+\max_i\{\delta_{t-1}(i)+\log A_{ij}\}$$입니다. 최댓값을 주는 이전 상태를 저장하고 마지막 승자부터 역추적합니다. 여기서 max를 logsumexp로 바꾸면 forward update가 됩니다. 최대 경로와 모든 경로의 합은 서로 다른 질문이므로 Viterbi 경로와 시점별 posterior 최댓값은 다를 수 있습니다. Stanford의 HMM 장에서 동적 계획법 관점의 설명을 더 볼 수 있습니다.
5. Python: 추론과 학습을 정직하게 구분하기
전체 스크립트는 log-space forward/backward와 Viterbi를 직접 구현합니다. 전이를 세는 함수는 next_index를 써서 세션 경계를 보존합니다.
from common import make_dataset, prepare_embedding
from sklearn.cluster import KMeans
from lesson08 import estimate_transitions

data = make_dataset()
_, Z, _, _ = prepare_embedding(data, n_components=6)
km = KMeans(n_clusters=6, n_init=10, random_state=7).fit(Z[data["train"]])
labels = km.predict(Z)
A = estimate_transitions(labels, data["next_index"], data["train"], 6)
print(A, A.sum(axis=1))
python lesson08.py --output outputs로 실행합니다. 전체 코드는 학습 군집의 평균·분산으로 대각 Gaussian emission을 초기화하고, 학습 세션의 시작 라벨로 초기분포를 만듭니다. Baum–Welch를 실행하지는 않습니다. Baum–Welch는 EM으로, 상태와 전이의 기대 횟수를 추론하고 매개변수를 갱신하는 일을 반복합니다. 좋은 확장 과제지만 현재 baseline이 했다고 주장해서는 안 됩니다.
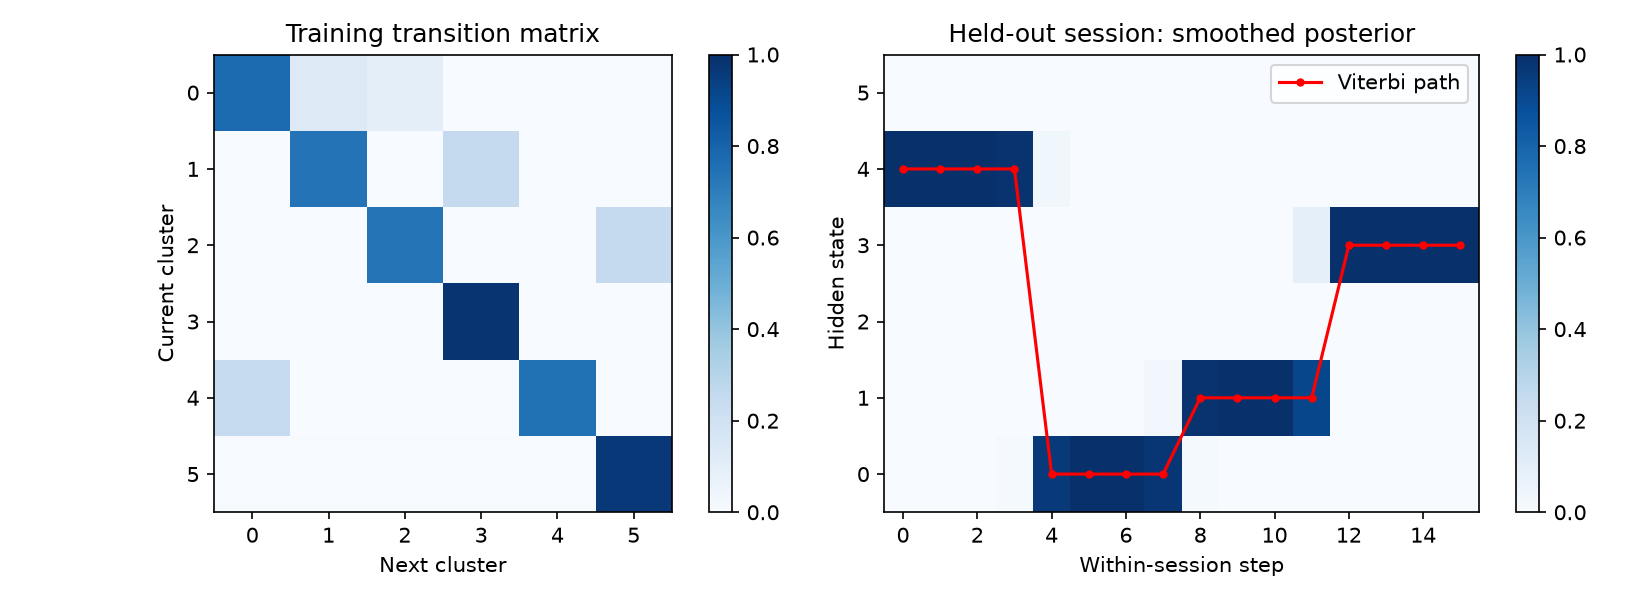
전이 평가 지표는 평가 세션의 다음 군집 negative log-likelihood이며 학습 데이터의 주변 빈도 baseline과 비교합니다. HMM 지표는 step당 관측 log density입니다. 서로 다른 예측을 평가하므로 한 점수처럼 수치를 직접 비교하지 않습니다. 그림의 posterior는 완성된 평가 세션 전체로 smoothing한 사후 분석입니다. 전체 세션을 단위로 나누므로 평가 세션의 미래 턴을 모델 학습에 쓰지는 않습니다.
6. 연속적인 State Space Model
숨은 상태가 범주 사이에서 점프하지 않고 연속 벡터로 바뀔 수도 있습니다. 선형 Gaussian 모델은
$$z_{t+1}=Fz_t+\epsilon_t,\quad \epsilon_t\sim\mathcal N(0,Q),$$$$r_t=Hz_t+\eta_t,\quad \eta_t\sim\mathcal N(0,R)$$입니다. 초기 상태가 Gaussian이고 잡음들이 독립 Gaussian이면 Kalman filter는 평균과 공분산을 재귀적으로 예측한 뒤 새 관측으로 보정합니다. 예측 평균을 $m_t^-$라 할 때
$$m_t=m_t^-+K_t(r_t-Hm_t^-)$$형태로 갱신합니다. 괄호 안은 예상 관측과 실제 관측의 차이입니다. Kalman gain $K_t$는 불확실성으로 정합니다. 관측 잡음이 크면 관측을 덜 믿고, 예측이 불확실하면 더 크게 보정합니다. Kalman 원논문은 이런 재귀적 추정 관점을 전개합니다. 일반적인 비선형 모델에서는 다른 추론이나 근사 방법이 필요합니다. 이름에 SSM이 들어간 모든 모델이 Kalman filter를 쓰는 것은 아닙니다.
7. 세포, 대화, 연습문제
바이오에서는 같은 세포를 추적한 반복 관측이 전이 추정을 뒷받침할 수 있습니다. 다른 시점에서 모은 서로 짝지어지지 않은 세포만으로 개별 전이가 저절로 주어지지는 않습니다. 캐릭터 채팅에서는 세션 안의 턴이 짝지어져 있지만, 턴 길이·화자·프롬프트·개입이 전이확률을 바꿀 수 있습니다. 그런 요소와 예측상 관련이 있다고 인과 효과가 되는 것은 아닙니다.
A,A,B와C,C를 smoothing 없이 세어 보세요. A는 A와 B로 각각 1/2, C는 C로 1입니다. B에는 관측한 다음 상태가 없으므로 데이터만으로 그 행을 추정할 수 없습니다.- 천 step의 확률을 그대로 곱하면 왜 곤란한가요? 아주 작은 값이 되어 underflow할 수 있습니다. 정규화된 forward message 또는 log probability와
logsumexp를 사용합니다. - 온라인 시스템이 그림의 smoothed posterior를 써도 되나요? 세션 중간의 예측 시점에는 안 됩니다. Backward가 미래 관측을 읽기 때문입니다. Filtering을 쓰고 예측 순간에 존재하는 정보만으로 평가해야 합니다.
이제 실제 전이 근거를 얻었습니다. 다음 강의에서는 이동의 크기와 방향을 vector field로 학습합니다.