경로는 시스템이 지나온 위치를 보여줍니다. **벡터장(vector field)**은 현재 위치에서 어느 방향으로 움직일지를 표현합니다. 지금까지 만든 상태 지도를 예측 모델로 바꾸는 단계입니다. 다만 화살표의 의미는 좌표계와 추정 근거에 의해 제한됩니다.
선수 지식과 수업 계획. PCA, 회귀, Markov 모델, 미분의 의미를 복습합니다. 90분을 차분 15분, 벡터장과 RNA 반응식 20분, Python 실습 35분, 오차 토론 20분으로 나눕니다. 목표는 올바른 인접 관측 쌍 구성, 한 단계 예측과 자유 전개 비교, RNA velocity와 채팅 변화량의 차이 설명입니다. 공통 실습 환경, 전체 코드, 전체 실습 ZIP을 사용합니다.
먼저 하나의 이동을 측정한다
가로축이 이야기 진행도, 세로축이 긴장도라고 합시다. 시간 2에 상태가 $(1,0)$이고 시간 2.5에 $(1.2,0.3)$입니다. 변위는 $(0.2,0.3)$이지만 평균 속도는 단위 시간당 $(0.4,0.6)$입니다. 관측 간격이 다를 때는 시간으로 나누어야 비교할 수 있습니다.
$$ \widehat v_i=\frac{z_{i+1}-z_i}{\Delta t_i},\qquad \Delta t_i=t_{i+1}-t_i>0. $$이 값은 구간의 평균 변화율입니다. 충분히 매끄러운 경로를 짧은 간격으로 관측할 때 미분에 가까워집니다. 채팅에서는 턴을 시간 단위로 정해도 됩니다. 다만 턴당 속도와 분당 속도는 다른 질문에 답합니다. 밤새 중단한 대화와 3초 만에 이어진 대화를 같은 시간 간격으로 취급할지는 분석 목적에 따라 결정해야 합니다.
분기에서는 같은 위치에서 위쪽이나 아래쪽으로 갈 수 있습니다. 제곱오차 회귀는 두 방향을 평균내므로 데이터가 없는 중간 방향을 가리킬 수도 있습니다. 상태 표현에서 버린 정보를 표본 수만 늘려 복원할 수는 없습니다. 과거 이력이나 문맥을 상태에 넣거나 다음 상태의 분포를 예측해야 합니다.
화살표들을 하나의 함수로 만든다
학습 목표는 관측된 변화량을 재현하는 함수입니다.
$$ \min_\theta\sum_{i\in\mathcal T} \left\|f_\theta(z_i,t_i)-\widehat v_i\right\|_2^2. $$실습에서는 입력에 시간을 포함합니다. $z$만 사용하는 모델은 같은 위치에 도달하면 시점과 관계없이 같은 평균 속도를 갖는다고 가정합니다. 산점도를 그렸다고 자동으로 성립하는 성질이 아닙니다.
이번 기준 모델은 입력이 가까운 학습 관측 40개의 속도를 평균냅니다. 신경망보다 구조를 읽기 쉽고, 잡음도 어느 정도 평활화합니다. 복잡한 모델을 도입한다면 먼저 새로운 세션에서 이 단순한 기준 모델을 이기는지 확인해야 합니다.
차분은 측정 잡음을 증폭합니다. 두 독립 측정값의 잡음 분산이 각각 $\sigma^2$이면, 차이를 $\Delta t$로 나눈 값의 잡음 분산은 $2\sigma^2/\Delta t^2$입니다. 관측 간격을 줄이기만 하면 미분 추정이 정확해지는 것은 아닙니다. 필요하면 반복 관측, 경로 평활화, 불확실성 모델을 사용하되 서로 다른 세션을 이어서 평활화하지 않습니다.
Python: 올바른 관측 쌍부터 만든다
공통 데이터에는 합성 세션 120개와 고정 관측 구간이 있습니다. 스케일링과 PCA는 학습 세션으로 적합합니다. 아래는 다운로드 코드의 관측 쌍 구성과 회귀 부분입니다.
import numpy as np
from sklearn.neighbors import KNeighborsRegressor
from common import make_dataset, prepare_embedding

data = make_dataset()
_, Z, _, _ = prepare_embedding(data)
current = np.flatnonzero(data["next_index"] >= 0)
following = data["next_index"][current]
dt = data["time"][following] - data["time"][current]
velocity = (Z[following] - Z[current]) / dt[:, None]
features = np.column_stack([Z[current], data["time"][current]])
fit = data["train"][current]
model = KNeighborsRegressor(n_neighbors=40, weights="uniform")
model.fit(features[fit], velocity[fit])
predicted = Z[current[~fit]] + dt[~fit, None] * model.predict(features[~fit])
압축을 푼 실습 폴더에서 python lesson09.py --output outputs를 실행합니다. 전체 스크립트는 시간 간격이 양수인지, 관측 쌍의 세션 ID가 같은지 확인합니다. z_true는 학습 입력에 넣지 않습니다. 단순히 인접 행끼리 빼면 한 사람의 마지막 상태에서 다른 사람의 시작 상태로 이동하는 가짜 화살표를 만들 수 있습니다.
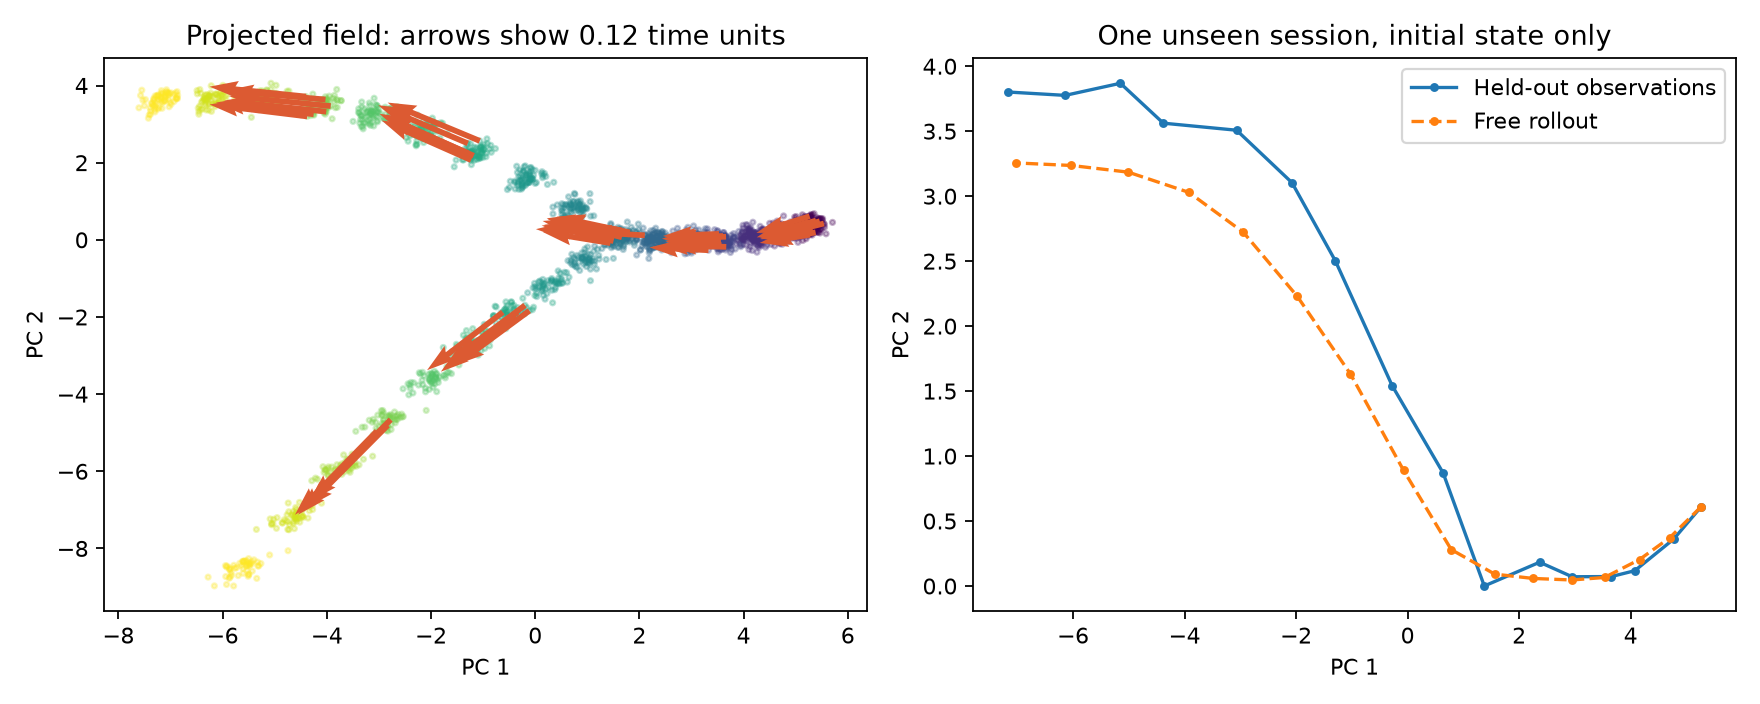
왼쪽 화살표는 0.12 시간 단위의 이동량으로 표시했습니다. 오른쪽은 평가 세션의 시작 상태만 주고 다음 식을 반복한 결과입니다.
$$ \widehat z_{k+1}=\widehat z_k+\Delta t_k f_\theta(\widehat z_k,t_k). $$한 단계 평가에서는 매번 실제 관측 상태를 입력합니다. 이는 teacher forcing과 같은 방식의 평가로, 자기 예측에서 누적된 오차를 견딜 필요가 없습니다. 자유 전개에서는 직전 예측을 다시 입력하므로 다른 문제가 됩니다.
제공한 시드의 실행에서 한 단계 MSE는 약 0.035, 현재 상태가 그대로 유지된다고 예측하는 기준값은 0.516입니다. 자유 전개 MSE는 약 7.51로 커집니다. 시작 위치에 계속 머무는 기준값 26.74보다 낫지만, 국소 예측의 성공이 긴 경로 복원을 보장하지 않는다는 점이 드러납니다. 이 수치는 좌표계에 의존하는 합성 데이터 오차이며 실제 생물학적 성능을 뜻하지 않습니다.
RNA velocity는 무엇을 더 알아내는가
일반적인 단일세포 RNA 시퀀싱에서는 측정한 세포를 다시 측정할 수 없습니다. 따라서 같은 세포의 내일 발현량에서 오늘 발현량을 빼는 방법을 쓸 수 없습니다. RNA velocity는 스플라이싱 전후 RNA 정보를 이용해 발현의 국소 변화율을 추정합니다. 최초 논문은 이 접근과 추정·시각화의 한계를 함께 설명합니다. La Manno et al., 2018
한 유전자의 단순한 반응식은 다음과 같습니다.
$$ \frac{du}{dt}=\alpha-\beta u,\qquad \frac{ds}{dt}=\beta u-\gamma s. $$$u$는 unspliced RNA, $s$는 spliced RNA이며 $\alpha,\beta,\gamma$는 전사, 스플라이싱, 분해 속도와 관련된 계수입니다. $u=4,s=3,\beta=\gamma=1$이면 spliced RNA 변화율은 $1$입니다. 다음 세포를 직접 본 결과가 아니라 반응 모델에 의한 추론입니다.
정상 상태나 반응 속도에 대한 가정이 깨지면 추정이 틀릴 수 있습니다. scVelo는 과도 상태를 다루는 동역학 모델로 확장하지만, 모델 오지정이나 불확실성 자체를 없애지는 않습니다. Bergen et al., 2020
채팅에는 순서가 있는 실제 관측이 있지만 임베딩은 인코더, 문맥 창 길이, 화자, 프롬프트에 영향을 받습니다. 이동 평균 문맥 창 자체가 매끄러운 경로를 만들어낼 수도 있습니다. 이번 코드는 서사 특징의 변화량을 추정하며 RNA velocity를 계산하지 않습니다.
좌표계가 결론을 제한한다
고정 선형 투영 $z=W^\top x$에서는 $v_z=W^\top v_x$로 속도를 투영합니다. 미분 가능한 비선형 인코더 $z=g(x)$에서는 $v_z=J_g(x)v_x$라는 국소 관계를 사용합니다. UMAP 그림 위에 화살표를 옮겨 그린다고 이 계산이 자동으로 이루어지지는 않습니다.
2차원에서 사라지는 방향도 있고, 시각화의 왜곡 때문에 속도가 달라 보일 수도 있습니다. 화살표 그림을 모델 진단으로 보고 실제 질문에 맞는 공간에서도 검증해야 합니다. 상태를 바꾸면 미래가 어떻게 바뀌는지는 별도의 인과 질문이며 12강에서 다룹니다.
연습문제
- 단위를 확인하기. 네 턴 동안 $(2,-1)$만큼 이동했다면 속도는? 답: 턴당 $(0.5,-0.25)$. 각 턴의 길이가 다르면 타임스탬프 없이 분당 속도로 바꿀 수 없습니다.
- 평가를 바꾸기. 자유 전개에서 입력을 매번 실제 평가 상태로 교체하면 왜 오차가 줄어들까요? 힌트: 모델이 자기 예측의 누적 오차를 감당할 필요가 없어집니다. 평가 대상이 달라진 것입니다.
- 빠진 기억 확인하기. 같은 2D 위치를 서로 반대 방향으로 통과하는 두 경로를 만드세요. 예상 결과: 평균 화살표는 거의 0이 될 수 있습니다. 입력에 이전 속도를 추가하고 새로운 세션에서 비교해 보세요.
다음 강의에서는 각 시점의 집단만 관측했을 때 어떤 이동을 추론할 수 있는지 살펴봅니다.