신경망으로 속도를 예측하고 수치 적분기로 상태를 조금씩 이동시키면 연속 경로 모델을 만들 수 있습니다. Neural ODE의 핵심입니다. 같은 장치로 확률분포 전체를 이동시킬 수도 있습니다. 다만 그 이동이 무엇을 의미하는지는 학습에 제공한 근거에 달려 있습니다. 실제 관측 시간과 생성 과정에 붙인 인공 시간은 서로 바꿔 쓸 수 없습니다.
선수 지식과 수업 계획. 미분, 신경망 회귀, 9강의 벡터장과 10강의 결합을 복습합니다. 100분을 ODE 20분, 확률성과 밀도 15분, Flow Matching과 Python 35분, 검증 30분으로 나눕니다. 목표는 실행 가능한 2D 생성 모델과 그 모델이 식별하지 못하는 대상을 설명하는 것입니다. 환경 설정, 전체 PyTorch 코드, 실습 ZIP을 사용합니다.
작은 이동은 잔차 업데이트다
$(0,0)$에서 일정한 속도 $(1,2)$로 시작합시다. $h=0.1$로 두고 $z\leftarrow z+h(1,2)$를 열 번 실행하면 $(1,2)$에 도달합니다. 속도를 학습하는 경우에는
$$ z_{k+1}=z_k+h f_\theta(z_k,t_k) $$가 됩니다. 이것이 명시적 Euler 방법입니다. 이 작은 업데이트가 근사하려는 연속 모델은
$$ \frac{dz}{dt}=f_\theta(z,t),\qquad z(t_1)=z(t_0)+\int_{t_0}^{t_1}f_\theta(z(t),t)\,dt $$입니다. 신경망은 미분값을 정하고 적분기는 경로를 계산합니다. 스텝을 줄이면 수치 오차는 줄일 수 있지만 잘못 학습한 벡터장을 고칠 수는 없습니다. 적응형 적분기는 허용 오차에 따라 계산량을 조정하며, stiff한 벡터장은 여전히 많은 계산을 요구할 수 있습니다. Neural ODE 논문은 학습하는 동역학과 수치 적분을 이렇게 연결합니다.
해의 유일성이 성립하는 정칙 조건에서, 완전히 같은 초기 상태는 결정론적 ODE를 따라 하나의 경로로 움직입니다. 초기 상태가 여러 위치에 분포하면 끝에서 두 군집을 만들 수 있지만, 이것은 동일한 개체 상태가 확률적으로 분기하는 것과 다릅니다. 같은 관측으로부터 여러 미래를 표현하려면 잠재 초기 상태의 불확실성, 조건 정보, 확률적 동역학 등을 추가해야 합니다.
잡음은 그림뿐 아니라 모델을 바꾼다
Itô SDE를 다음처럼 씁니다.
$$ dz=f_\theta(z,t)\,dt+\Sigma(z,t)\,dW_t. $$Drift $f_\theta$는 국소 평균 이동을, diffusion 행렬 $\Sigma$는 무작위 변동을 조절합니다. $W_t$는 Brownian motion입니다. 시간 $h$ 동안 증가량의 분산이 $h$에 비례하므로 Euler–Maruyama 방법은
$$ z_{k+1}=z_k+h f_\theta(z_k,t_k)+\sqrt h\,\Sigma(z_k,t_k)\xi_k, \qquad \xi_k\sim\mathcal N(0,I) $$를 사용합니다. $\sqrt h$ 대신 $h$를 곱하면 스텝을 줄일 때 잡음의 성질이 달라집니다. 상태에 따라 잡음 크기가 변하면 Itô와 Stratonovich 해석의 drift가 다를 수 있습니다. 여기서는 Itô 표기를 사용하고, 실습은 결정론적 경우만 구현합니다.
Flow는 확률밀도도 이동시킨다
가역 변환 $y=g(x)$에서는 변수변환 공식으로
$$ \log p_Y(y)=\log p_X(x)-\log|\det J_g(x)| $$가 됩니다. Normalizing flow를 이해하는 출발점입니다. 충분히 정칙인 연속 flow에서는 이에 대응하는 국소 식이
$$ \frac{d}{dt}\log p_t(z(t))=-\nabla\!\cdot f_\theta(z(t),t) $$입니다. 부피를 늘리는 장에서는 경로를 따라 밀도가 낮아집니다. 경로 학습과 분포 모델링이 같은 수학을 사용할 수 있는 이유입니다. 이번 실습은 likelihood나 divergence를 계산하지 않고 속도를 학습합니다. Flow를 정의한다고 해서 계산하지 않은 likelihood를 성능 지표로 보고하면 안 됩니다.
Flow Matching은 회귀용 정답을 만든다
이른 상태 $x_0$와 늦은 상태 $x_1$을 뽑고, 인공 시간 $t\in[0,1]$을 무작위로 선택합니다.
$$ x_t=(1-t)x_0+tx_1,\qquad u_t=x_1-x_0. $$두 점을 잇는 직선이 입력과 정확한 조건부 속도를 동시에 제공합니다. 따라서
$$ \mathcal L(\theta)=\mathbb E_{x_0,x_1,t} \left\|f_\theta(x_t,t)-(x_1-x_0)\right\|_2^2 $$를 최소화하면 됩니다. 서로 다른 끝점 쌍이 비슷한 $(x_t,t)$를 지나면서 다른 속도를 요구할 수 있습니다. 제곱오차 회귀는 그 조건부 평균을 배웁니다. 적절한 가정과 이상적인 학습 조건에서 이 평균장은 선택한 확률 경로의 분포를 이동시킵니다. 실제로는 데이터 수, 신경망 용량, 최적화 오차가 남습니다. 학습 스텝마다 ODE를 풀지 않고 속도를 회귀하는 접근이 conditional Flow Matching의 장점입니다. Lipman et al., 2022
끝점의 결합도 설계 선택입니다. 이번 실습은 두 끝점을 독립적으로 뽑습니다. OT 결합을 사용하지 않으며, 세션의 숨은 개체 대응을 복원하지 않습니다. 학습용 조건부 경로를 직선으로 만들었다고 생성되는 모든 경로가 직선이 되는 것도 아닙니다.
Python: 벡터장을 학습하고 적분한다
앞 강의와 같은 합성 관측을 사용합니다. PCA와 추가 좌표 표준화는 학습 세션에서만 적합합니다. 이른 관측($t_{\mathrm{obs}}\leq0.15$)을 출발 분포로, 늦은 관측($t_{\mathrm{obs}}\geq0.85$)을 도착 분포로 사용합니다. 네트워크는 64개 유닛의 은닉층 두 개를 가지며 상태 좌표 두 개와 보간 시간을 입력받습니다.
아래 코드는 다운로드한 구현을 이용해 전처리, 700회 미니배치 업데이트, Euler 적분, 검증을 모두 실행합니다.
from pathlib import Path
from lesson11 import run

metrics = run(Path("outputs"))
print(metrics["endpoint_sliced_w1"])
print(metrics["euler_refinement_rmse"])
python lesson11.py --output outputs로 실행해도 됩니다. 전체 코드의 학습 루프는 끝점 쌍 128개를 뽑고, 볼록 보간을 만든 뒤, 속도 MSE를 Adam으로 최적화합니다. CPU에서 구조를 직접 읽고 바꿔 보기 위한 작은 모델입니다.
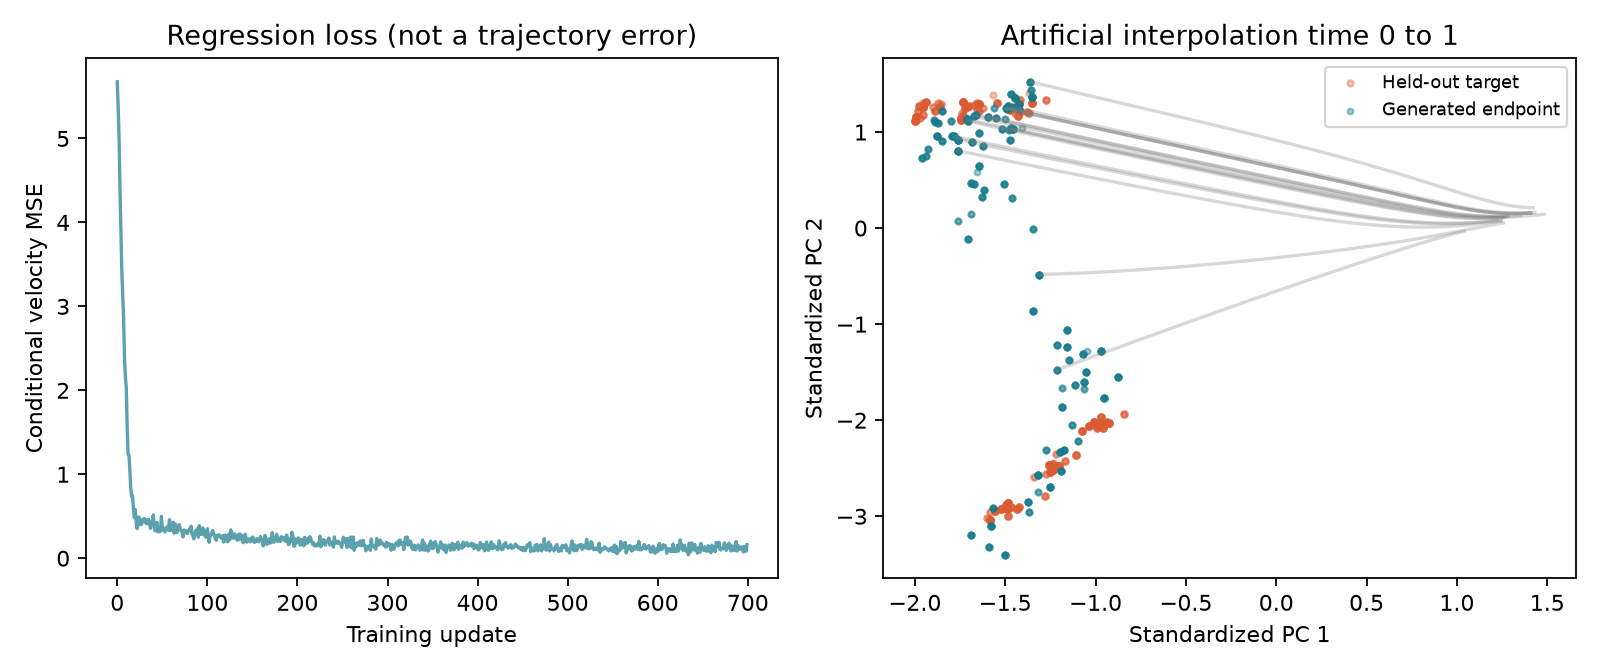
평가는 학습에 없던 세션의 이른 상태에서 시작해, 생성된 끝점 집단을 평가 세션의 늦은 상태 집단과 비교합니다. Sliced $W_1$ 진단값은 64개 방향으로 투영하고, 각 투영값을 정렬한 뒤 대응 분위수의 절대 차이를 평균냅니다. 개체별 경로 오차가 아닌 분포 간 비교입니다.
제공한 시드에서 이 값은 이동 전 약 2.17에서 이동 후 약 0.45로 줄어듭니다. Euler 스텝 수를 80에서 160으로 늘렸을 때 같은 초기 표본의 끝점 RMSE 차이는 약 0.024입니다. 앞의 지표는 분포 일치, 뒤의 지표는 수치 계산 민감도를 봅니다. 어느 쪽도 생물학적 동역학의 정확성을 증명하지 않습니다. 학습 손실만 낮은 것은 더 약한 근거입니다.
생물학적 시간이라는 주장은 별도로 검증한다
실제 반복 관측에 적합한 모델은 시간 동역학 예측을 시도할 수 있습니다. 그래도 적절한 상태 변수, 시간 검증, 불확실성 분석이 필요합니다. 이번 생성 모델은 끝점 분포와 인공 보간만 배웁니다. 같은 끝점 분포를 연결하는 중간 경로는 여러 개입니다.
바이오에서 매끄러운 생성 경로는 집단 이동에 대한 가설을 제시할 수 있습니다. 이를 검사하려면 중간 시점의 측정과 개입이 필요합니다. 캐릭터 채팅에서 “도입”과 “해결”의 임베딩을 연결한 경로는 실제 대화가 도달할 수 없는 위치를 지날 수 있습니다. 디코딩, 문맥 일관성 조건, 실제 미관측 세션과의 비교는 추가 검증이며 끝점 일치만으로 자동 충족되지 않습니다.
Schrödinger bridge는 기준 확률과정을 두고, 그 과정과 상대 엔트로피가 가까우면서 양 끝 분포를 맞추는 경로 분포를 찾습니다. 확률적 제어와 수송을 잇는 확장이지만 이번 독립 끝점 Flow Matching 실습의 다른 이름은 아닙니다. De Bortoli et al., 2021
연습문제
- 오차 분리. 재학습 없이 Euler 스텝 크기만 절반으로 줄이면 어떤 오차가 개선될까요? 답: 수치 적분 오차입니다. 표현 오차, 추정 오차, 끝점만으로 생기는 식별 문제는 남습니다.
- 잡음 단위. $\sigma=2,h=0.01$일 때 한 스텝의 잡음 표준편차는? 답: $\sigma\sqrt h=0.2$이며 $0.02$가 아닙니다.
- 학습하지 않은 것 검증. 생성 경로를 실제 평가 세션의 중간 관측과 비교하세요. 힌트: 끝점의 분포가 비슷해도 시간 경로는 틀릴 수 있습니다. 보고서에서 보간 시간과 관측 시간을 다른 이름으로 표시하세요.
마지막 강의에서는 경로의 결과를 예측하고, 입력을 바꾸는 행위에 인과적 의미를 부여하려면 무엇이 필요한지 살펴봅니다.